Workflow · 实况记录
把这套 skill 走一遍:
从拷问到复盘的一份实况
Matt Pocock 的 skill 不是十几个独立工具,是一条有先后、有出口的流水线。这篇不解释名词,而是把整条线真跑一遍:在 JLPT 学习站里新开一个「假名翻牌」练习模块,每一步都留下可打开的东西——样张、规格、票、分支、PR、复盘。
八格是同一条线,不是八个工具:每一格的输入都是上一格的产物,除了第 06 格可以随时回去把第 03 格挖深一层。下面按这个顺序走,每格都带一个真产物。
先别动手:问地图,再摸地
ask-matt 路由 · research 后台调研 · 前置 setup-matt-pocock-skills 只装一次
这套 skill 的入口不是「找一个技能」,而是「先认路」。ask-matt 里只有一张表:你现在处在哪一段,该叫谁。它把整条线分成三段——想清楚(grill-with-docs → handoff / prototype)、写成规格再切票(to-spec → to-tickets)、实施与收尾(implement | implement-spec → pr → retro),另有三条岔路(triage / diagnosing-bugs / wayfinder)和一套给「重构老代码」用的健康检查。
做一个 mattpocock skill 的 workflow 的 html。页面分为两部分,左右,左小右大,
左边竖列排列 skill 的介绍和使用场景。一个一个 skill 一个模块。右边是正文。
从头到尾的先以流程为大体框架。主要内容是做一个案例。一步步介绍,
案例里面要有每一步的截图。主要产物。等。
按地图,这句话落在「想清楚」这一段——但有个陷阱:想清楚的前提是知道这块地上已经有什么。这个仓库是静态站,门户、测试、行尾、数据管线都有既成规矩,凭印象改必然踩。所以先派了一个只读的 research 子代理去把「新增一个顶级模块要动哪些地方」查清楚,主线程同时继续访谈。
不是一篇散文,是一串带行号的坐标:门户卡片在哪一行、哪三处断言写死了卡片数、进度模块的白名单为什么不许扩、行尾规则钉在哪个文件。这些坐标后来直接变成了实施阶段的硬约束——子代理拿到的任务书里,每条约束都能追到行号。
index.html:1610-1667   日语组 8 张卡,全部手写;data-tags 必须在词表内
index.html:1593-1599   data-tags 受控词表(全部/资料/词汇/听力/真题/练习/工具)
tools/tests/test_area.js:48        写死「12 张卡」
tools/tests/test_reading.js:283    写死「12 张卡」
tools/tests/test_typing_en.js:380  写死「12 张卡」
index.html:1553-1586   左栏 11 个 .rail-item(与 shell.mjs 的 12 个 ITEMS 早已不同步)
assets/progress.js:60  RE_UNIT 白名单不含新目录 → 新模块默认不计进度
typing/typing.js:48    独立 localStorage 键先例:jlpt-typing-best
这一步没有产物入库(调研笔记放在仓外的 .scratch/),但它改变了后面所有决定:模块不引共享样式、不接进度模块、不往左栏加条目、三处断言同批改。调研的价值不在结论正确,在于它把「猜」换成了「查过」。
拷问:把「做一个游戏」问成九条不能反悔的决定
grill-with-docs = grilling(拷问)+ domain-modeling(顺手写 ADR 与术语)
grilling 的规矩很硬:一次只问一个问题,等你答完再问下一个;每问必带「推荐答案 + 理由」;不许把选项写成一大段让人自己挑。它的目标不是收集需求,是把含糊处逼到不能含糊——因为含糊的每一处,后面都会变成返工。
这一轮被问掉的东西,事后看分成三类:
| 类别 | 被问的是什么 | 答完改变了什么 |
|---|---|---|
| 不可逆 | 案例是真的跑一遍,还是编一个? | 真跑:于是有了真实分支、真实提交、真实 PR,报告里的每个截图都能点开核对 |
| 不可逆 | 新开一个模块,还是塞进现有模块? | 新开:于是「新增顶级模块」这条最贵的路径被完整走了一遍,包括门户与文档的七处同步 |
| 便宜但影响全篇 | 左栏放几个 skill? | 十四个模块 + 一张路由表:够覆盖主线,又不至于变成名词表 |
| 便宜但影响全篇 | 截图是真截,还是画示意图? | 真截:界面用无头浏览器出图,会话过程用终端卡讲真实文本 |
| 口味 | 案例做什么题材? | 假名翻牌:练的是「配对回忆」,正好补上站里单向练习的空缺 |
九轮之后,谈定的话被写成一张表:每一个决定都带一句「为什么」。这是整条流水线里最便宜、也最省事的产物——后面每个子代理都拿它当输入,没有人再问「为什么不用另一种做法」。
| 决策       | 结论                                                    |
| 案例真实性 | 真跑一遍流程,产物真落盘                                  |
| 主构建技能 | implement-spec(implement 作补充说明)                    |
| 牌面与档位 | 三档 = 三种配对:假名↔罗马音 / 汉字词↔读音 / 日语词↔释义  |
| 分支与 PR  | 从 main 切 feat/kana-memory,draft PR base = main         |
| 视觉方向   | B · 纸感卡片墙(三张样张对比后用户选定)                    |
拷问的规矩是「只问决策,事实自己去查」。但第一轮我把「这个仓库的测试是怎么跑起来的」也列成了问题——那是事实,查一下就有,问用户等于把成本转嫁给他。用户当场纠正:事实性问题去查文件、查工具,只把决策留给人。这条纠正后来写进了本地约定,也直接决定了后面每一轮都先派调研再提问。
grill-with-docs 比 grilling 多一件事:问的同时把文档写掉。本案例里落的是三条术语(牌墙 / 一局 / 配对)与一份 ADR——「为什么再开一个顶级模块,而不是塞进现有模块」。写文档不是为了留痕,是为了让下一个会话不必重新论证。
样张:三个能打开的答案,比一段文字描述有用
prototype — 一次性代码,只为回答一个问题
prototype 的第一句话是:问题决定形状。要验数据模型,就写成几行脚本把状态打出来;要验界面,就写一个能点的页面。它的产物是「答案」,代码本身该扔——所以本案例的三个样张都放在仓外的 .scratch/ 里,一个字节都不入库。
要问的问题是「这个游戏该长什么样」。这种问题用文字回答必然错位:说「纸感」三个人会想到三张纸。于是同一副牌、同一条洗牌种子、同一组预置状态(已配对一对、已翻开一张),写成三个方向完全不同的页面,再加一页目录说明各自在回答什么:
- A · 绒布牌桌:深绿felt、奶油牌、金线,翻牌是三维翻转。押的是「像在桌边玩」的沉浸感。
- B · 纸感卡片墙:纸底、细线网格、墨色正文、朱色强调,配对成功给淡朱底+勾。押的是「和这个站的气质是一家人」。
- C · 和纸双色:和纸底、藍与朱、明朝体、发丝线,配对后盖一枚朱色小印。押的是「日式印刷品」的调子。
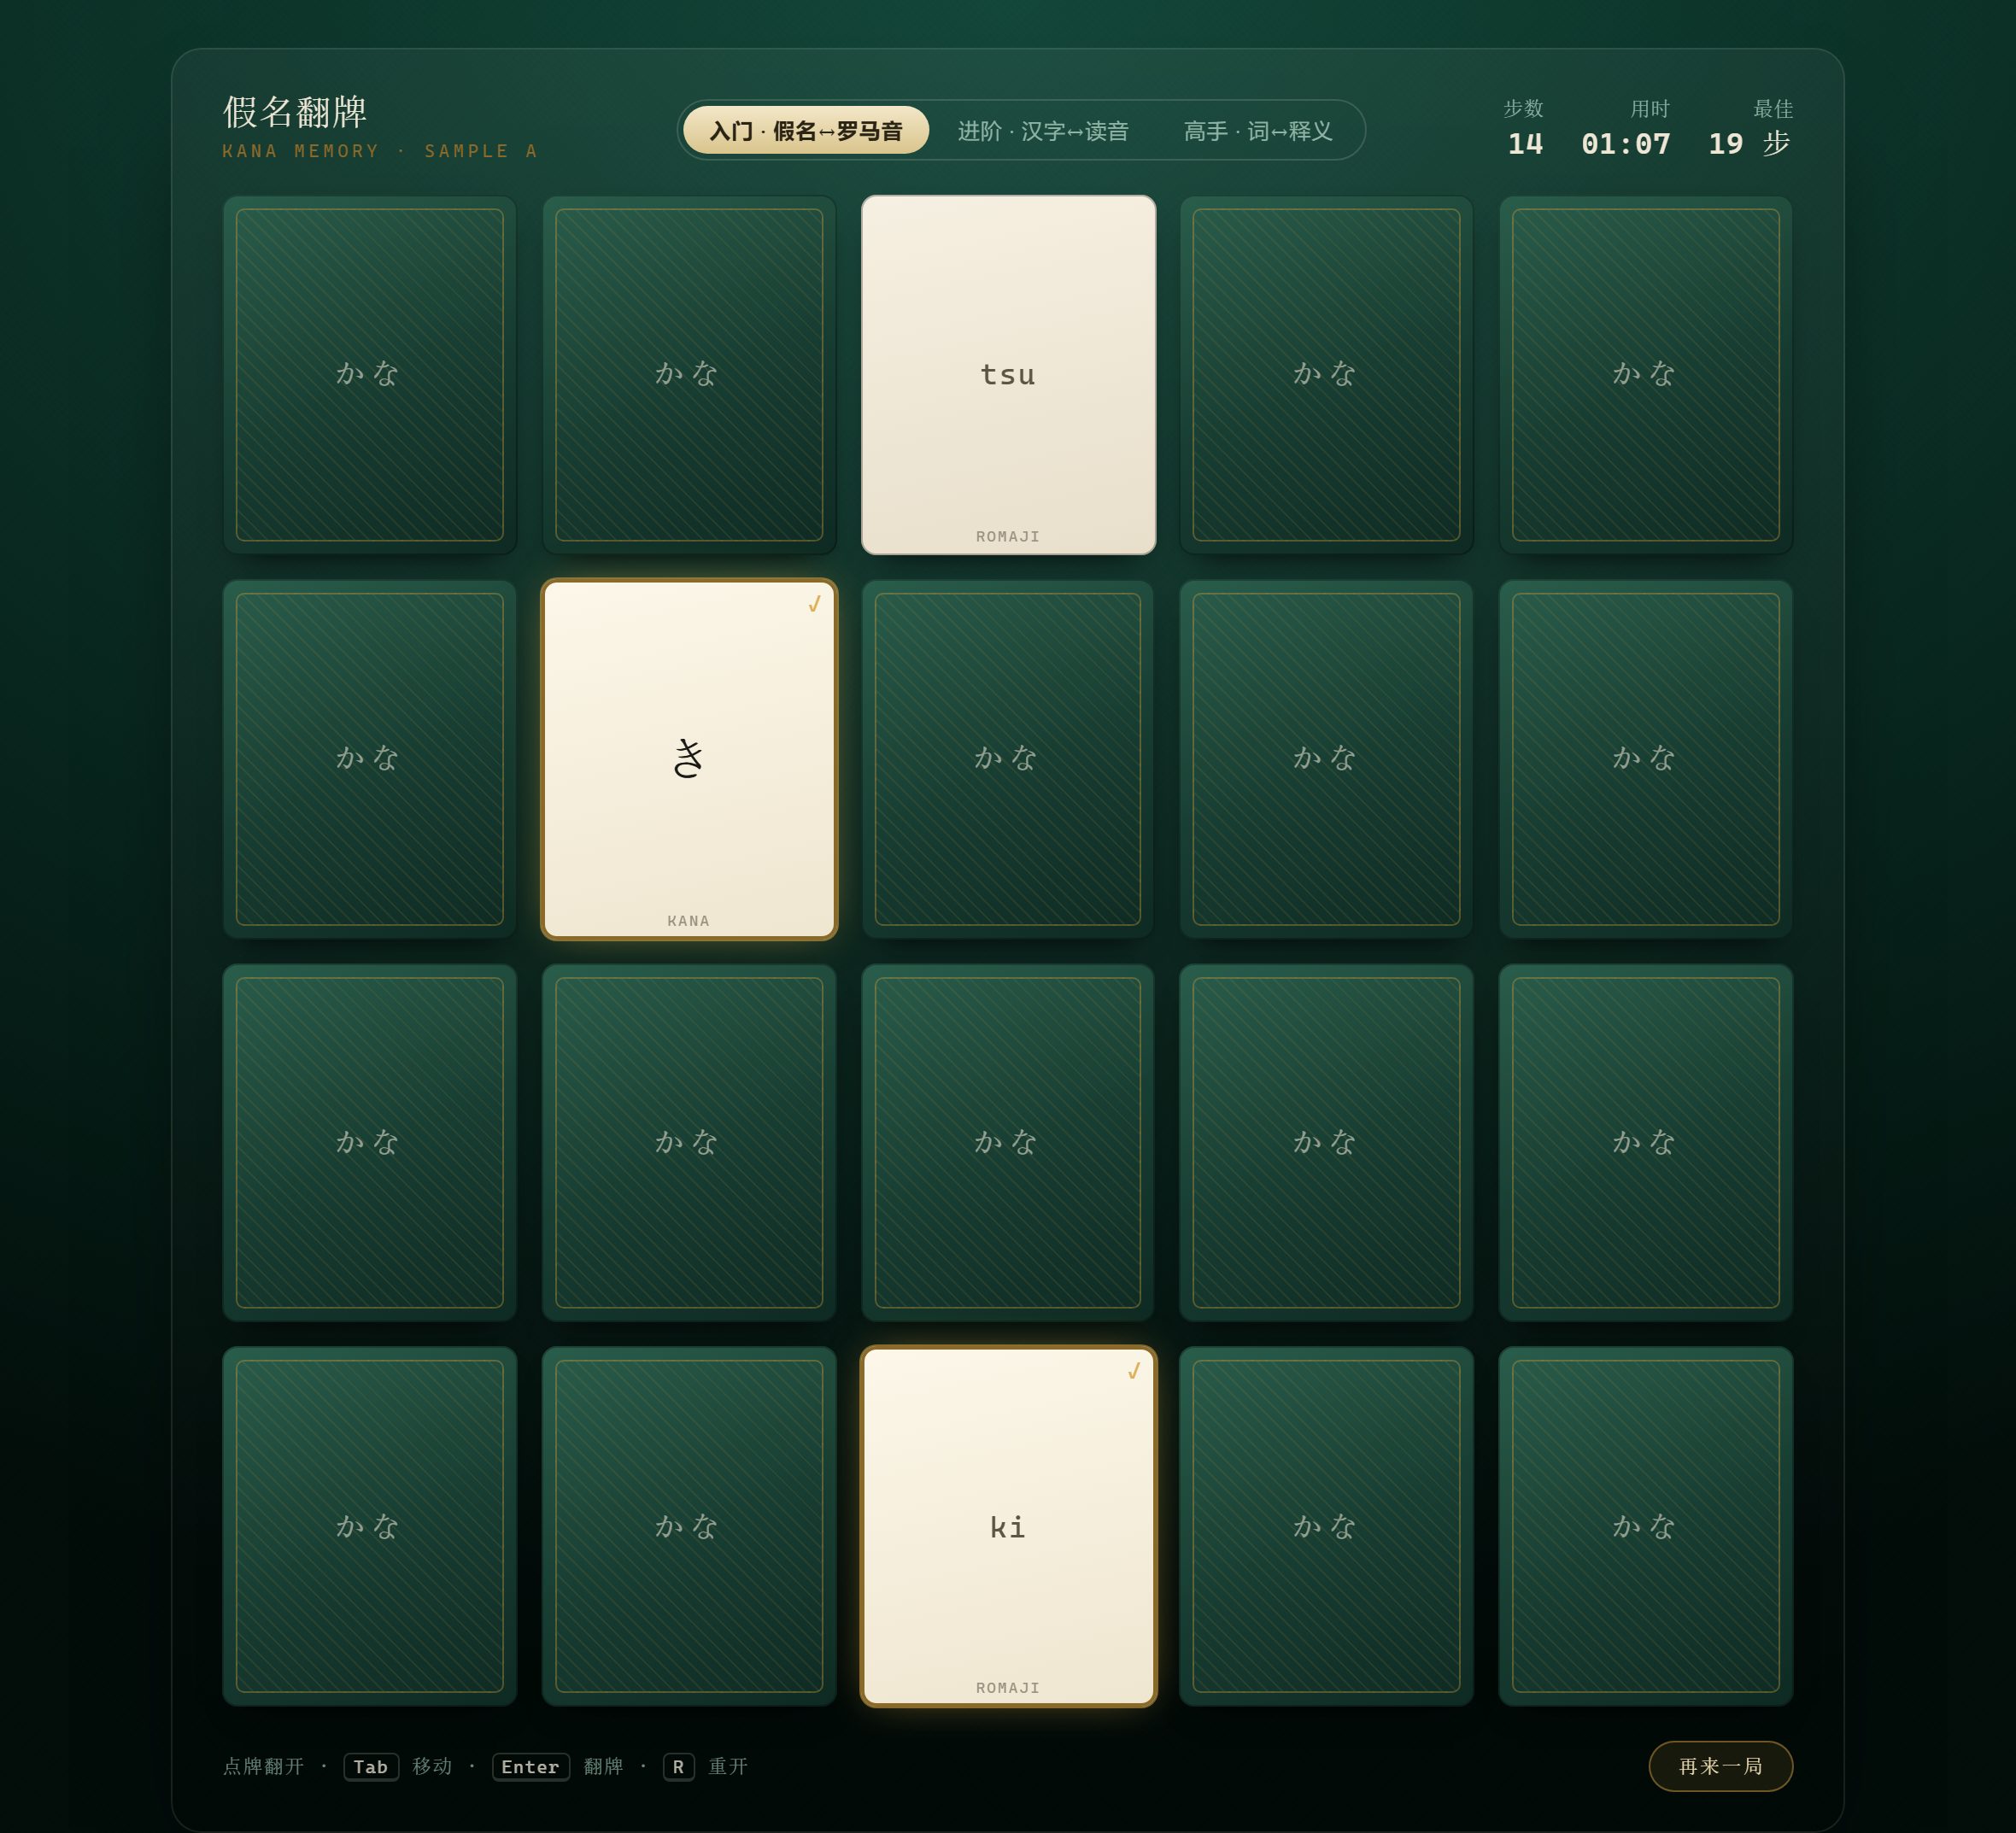
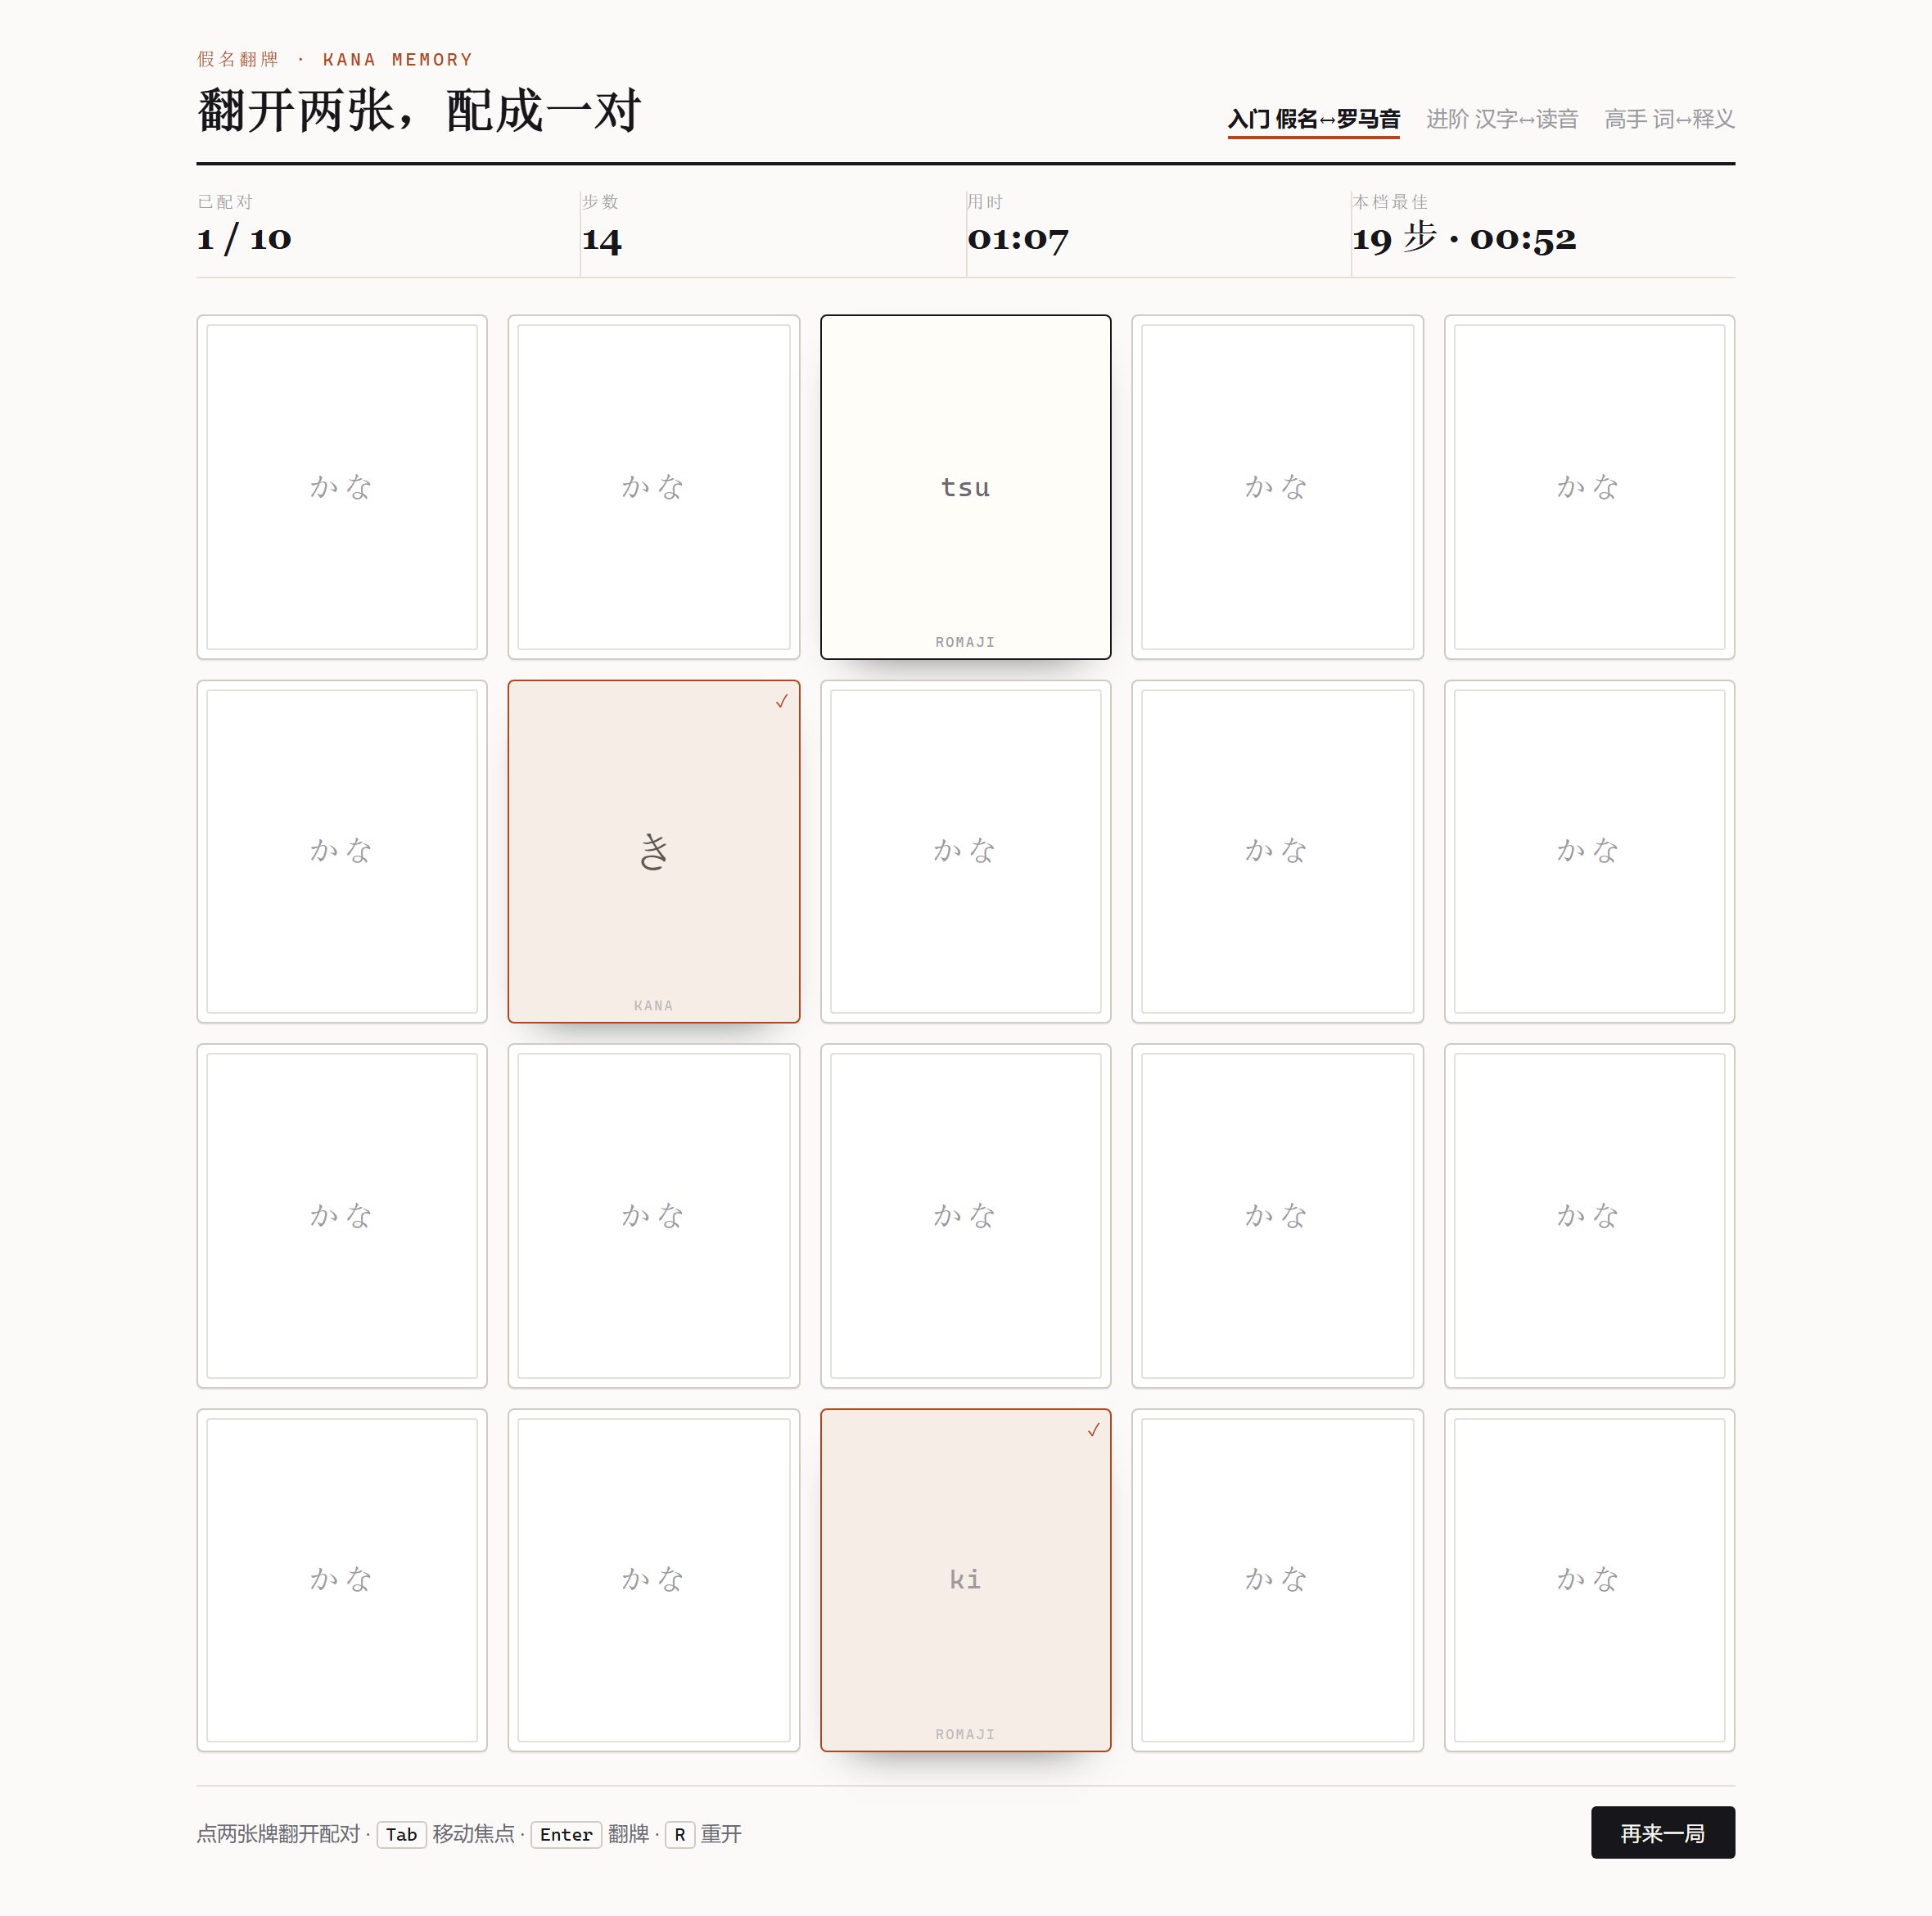
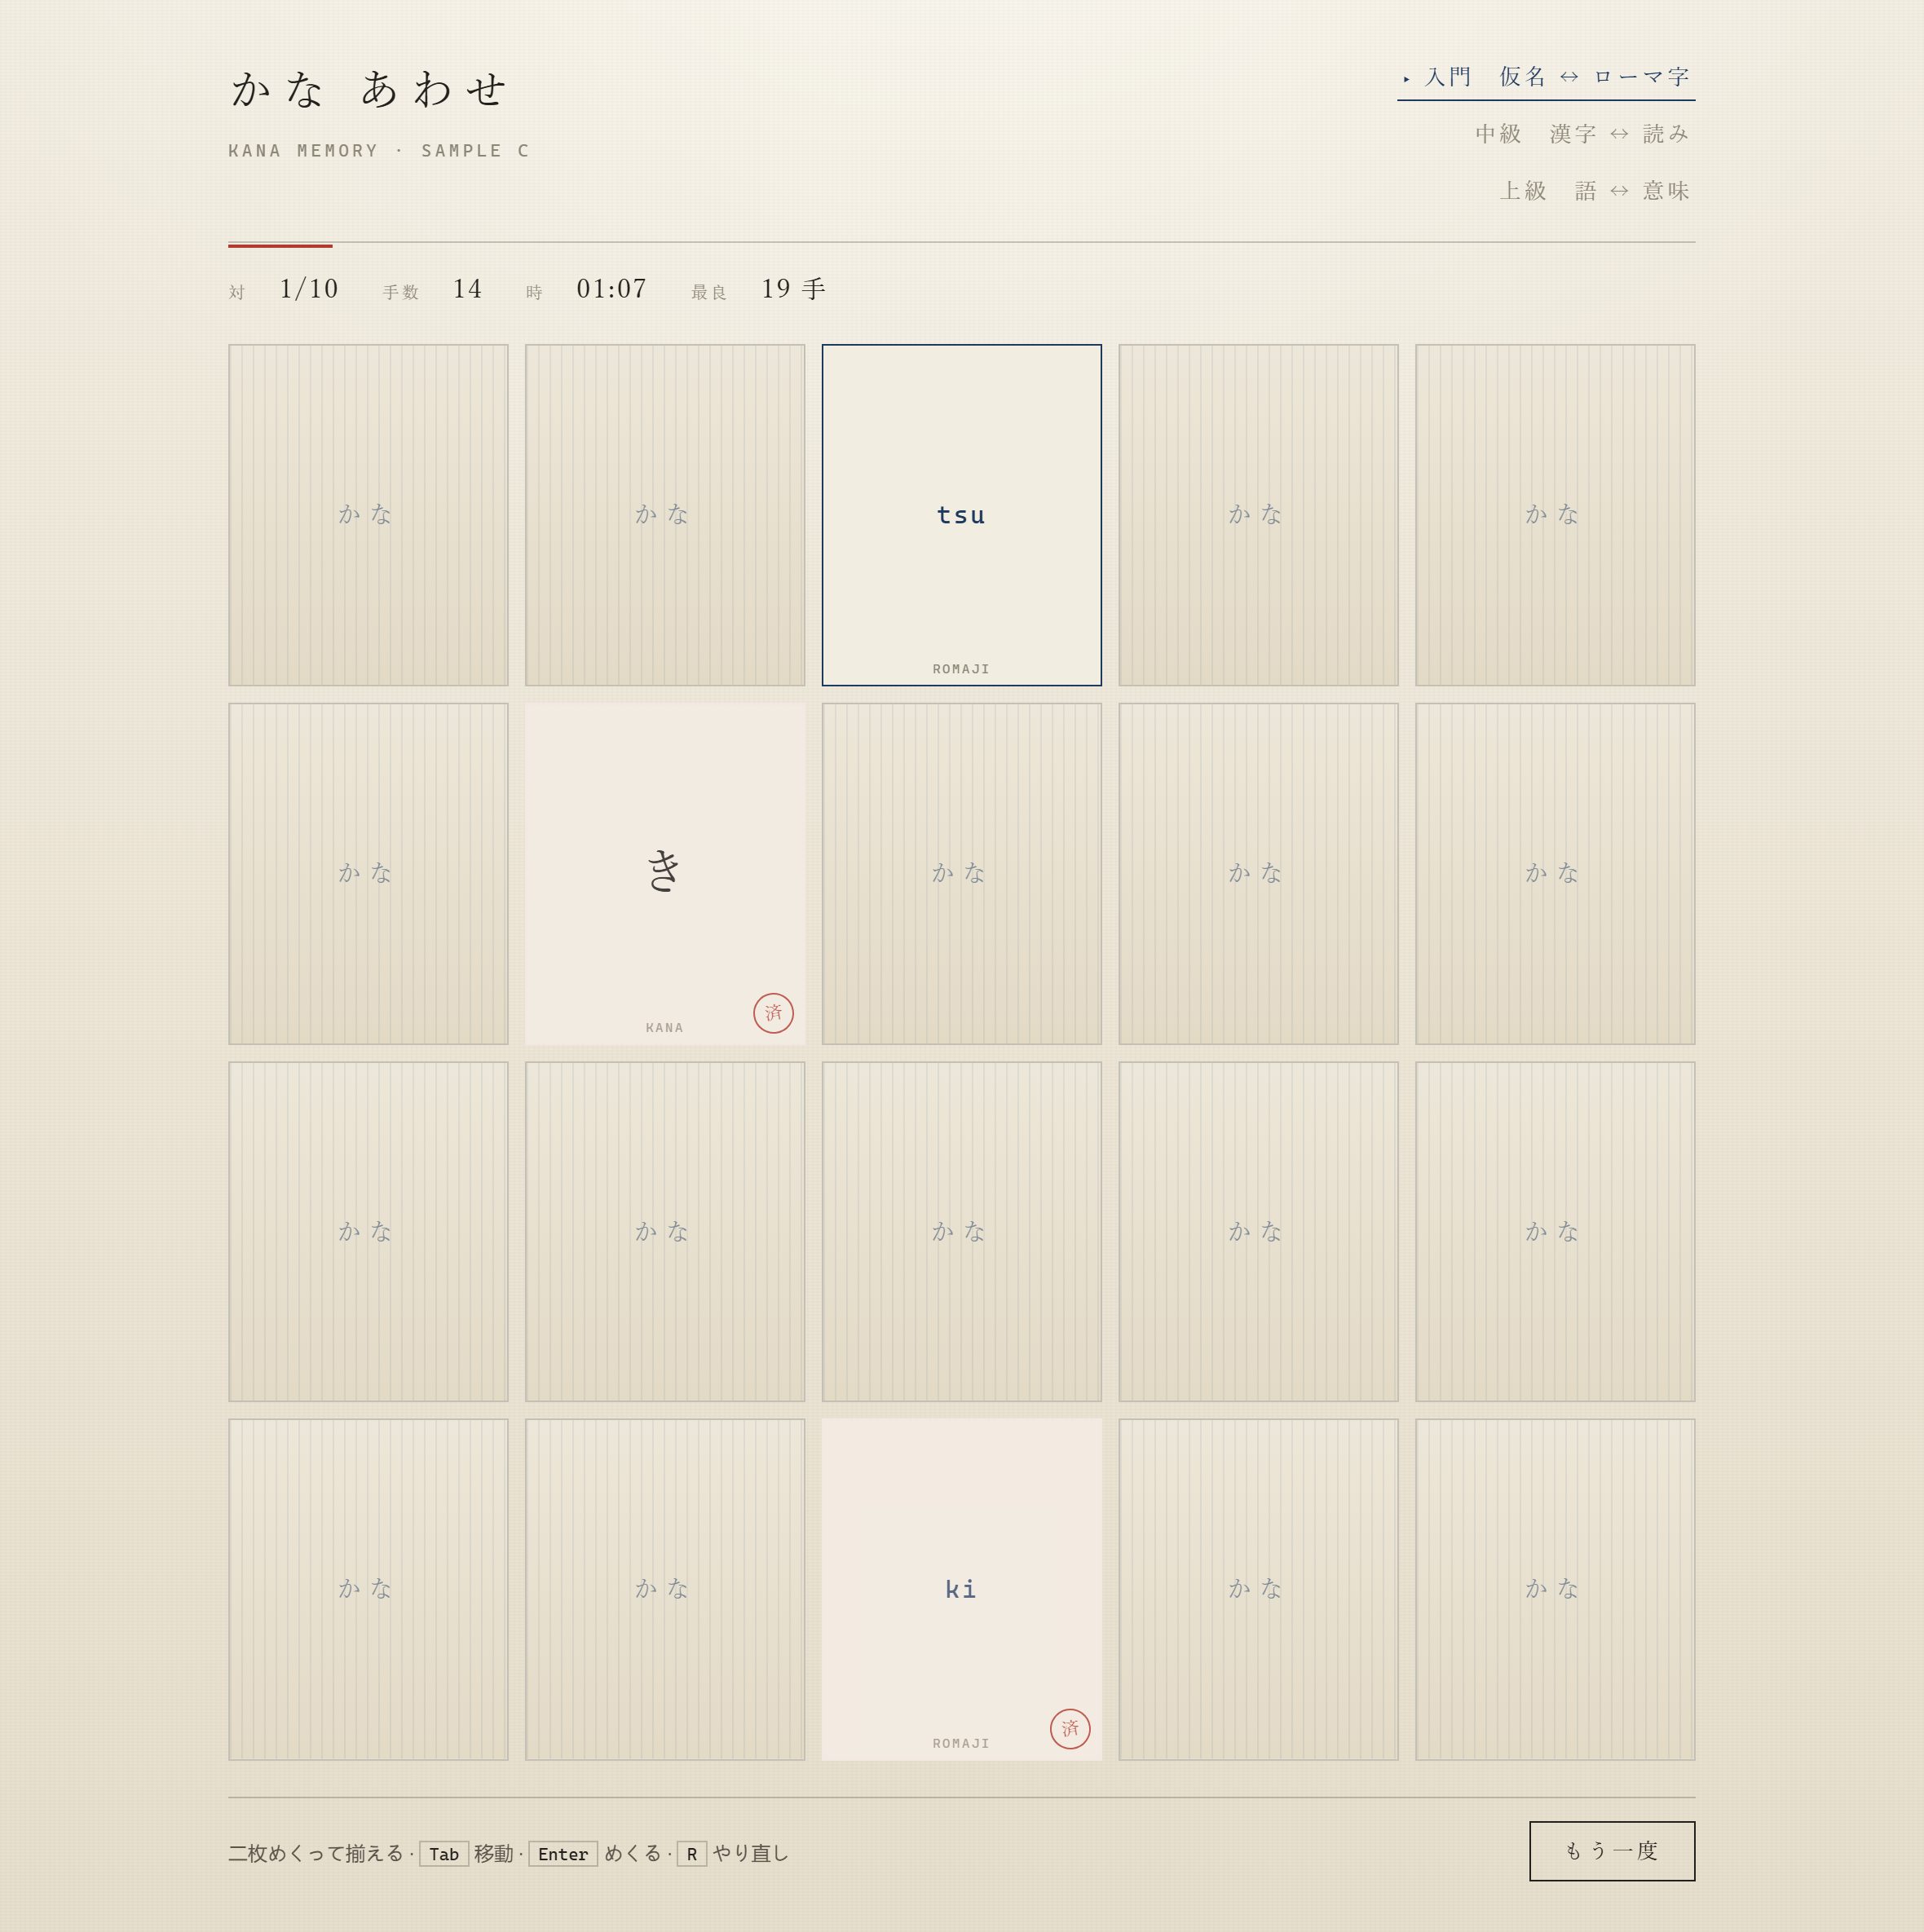
用户看着三个能点的页面选了 B。这个选择不只定了配色,还定了一串下游决定:既然走纸感,就不该引站里那套无衬线设计令牌(那会把共享样式表拖成调色板),于是模块自带一份 CSS,走 typing/ 那条「不引共享资源」的老路。一个视觉选择,最后变成了一条架构边界。
一、洗牌写错看不出来。三张样张的洗牌数组只用了 0–9 的重复值去索引 20 张牌,牌墙上于是出现两张「き / ki」——看图时才发现的。修法不是删重复,而是换成带种子的 Fisher–Yates:样张要能复现,靠随机数就复现不了。
二、居中会把证据裁掉。样张 A 用 flex 垂直居中,内容一旦高过视口,顶部那排计量(步数 / 用时 / 最佳)在整页截图里就整体消失。截图工具没错,是布局把信息推出去了——判断一个样张能不能用,先看它在截图里还剩下什么。
规格:把谈定的话压成一份能照着写的文件
to-spec — 不访谈,只综合
to-spec 的第一句就是禁令:不要再问用户,把你已经知道的写成规格。它要的产物不是会议纪要,而是这样一份文件:读完之后,一个没参加过对话的子代理能照着写代码,而且知道哪些事不该做。
写规格前还剩最后一个真决策没落:测试从哪儿进。这不是口味题,它决定了后面所有测试的形态,也决定了这个模块能不能被并行开发。问题是这么问的:
这个模块的算法只有十行(洗牌 + 比 key),风险全在接线:同 id 判定、翻开与配对的互斥、
配错后的定时回翻、计步时机、换档重建牌墙。测试接缝放哪儿?
A. 只测纯逻辑层 —— 快,但上面那些风险一条都测不到
B. DOM 桩驱动真页面脚本 —— 用仓库已有的 VM + 桩路线,慢一点,接线全在射程内
C. 装 jsdom —— 最省事,但要引入外部依赖,破仓库「零依赖」硬约束
选了 B。理由写在规格里,一句话就能服人:「只测纯函数会把五个真风险全漏掉」。这条决定还带出一个副产物:仓库原有的 DOM 桩 classList 是空实现,断不到「已配对」这种状态,于是新套件自带一个把 classList 做真的最小桩——不引依赖,只补缺的那一块。
## Problem Statement      练习都是单向的:敲字只练输出,翻转卡没有对局
## Solution               10 对 / 20 张的牌墙;三档 = 三种配对关系
## User Stories           16 条,逐条写「作为谁 / 我想要 / 以便」
## Implementation Decisions
   · 模块边界            新目录,走 typing/ 的「不引共享资源」路线
   · 数据来源            复用 typing/romaji.js 与 typing/data/*.js,不复制表
   · 一局的定义          10 对 20 张、5 列 4 行、步数 = 翻满两张算一步
   · 持久化              只两个 localStorage 键;不动 progress.js 的白名单
   · 交互与反馈          翻牌/配错/配对三态;结算条;键盘;aria-live
   · 门户接入            加一张手写卡,不加 rail-item,三处断言 12 → 13
   · 架构记录            要 ADR,要术语
## Testing Decisions      接缝 = DOM 桩;什么算好测试;要测的九件事
## Out of Scope           七条「不做」,其中两条是别人踩过的坑
十六行 Out of Scope 是这份文件里最容易被跳过、也最值钱的一节。它把「不接进度模块」「不加左栏条目」「不做音频文件」「不改 typing/」逐条写成白纸黑字——后面三个子代理各自独立干活时,谁都可能顺手「改进」其中一条,而这一节给了它们说不的依据。事实上有一次差点破线:进阶档想给牌面小字换个更准的标签,方案里第一反应是「顺手把 CSS 也调一下」,被「票 04 独占 kana.css」和这条边界拦住了。
访谈阶段的施工单里,模块目录写的是 memory/;到规格阶段定稿成 kana-memory/。这种漂移在任何项目里都会发生,危险的是它悄悄分裂:票里写一个名字、测试断言另一个名字、文档再写第三个。定稿的规格把它锁成一个词,后面所有票、分支名、路径、文档行都从这一个词派生。
切票:切成能单独合进去的小刀,而不是按层次切
to-tickets — tracer bullet + 声明的阻塞边
切票最自然的错法是按代码分层切:先做数据层、再做状态层、最后做界面层。这样切的每一刀都看不见东西——数据层写完,页面上什么都没有,没法验证、没法截图、也没法给别人看。to-tickets 要的是另一种切法:每一张票都是一颗能打到目标的子弹,合进去之后立刻能在页面上看见一点新东西。
这个模块被切成五张:
01 一局能玩(入门档)            ← 无阻塞,第一颗子弹
 │
 ├─→ 02 进阶档 + 档位切换
 │      │
 │      └─→ 03 高手档 + 每档最高分
 │                │
 │                └─→ 05 门户接入与文档
 └─→ 04 手感与可达性(只依赖 01,故可与 02 并行)
看这张图就能看出为什么它值钱:01 一落地,前沿就有两张票(02 和 04),可以同时派两个子代理;03 等 02、05 等 03,串行的那一段只剩两张。并行度不是靠人多,是靠依赖边画得准。
一张票长这样——短、硬、可判:
# 02: 进阶档 汉字词 ↔ 假名读音 + 档位切换

**What to build:** 页面顶部出现三个档位(入门 / 进阶 / 高手),点「进阶」重建牌墙:
牌对改为从 typing/data/{n5,n4}.js 抽的汉字词与其假名读音(如 兄 ↔ あに),步数、用时、
配对数全部归零并从这一刻重新计时。纯假名词(汉字写法与读音相同)不进牌池。

**Blocked by:** 01

**Status:** ready-for-agent

- [ ] 三个档位可切换,当前档位有可见的选中态
- [ ] 切到进阶档后牌池全部来自词表条目,且不含 w === k 的词
- [ ] 换档会重建牌墙(牌数与行列不变)、步数 / 用时 / 配对数归零
- [ ] 换档后计时不继续累加,直到下一次翻牌才重新起跑
- [ ] 当前档位在刷新后仍然保留
- [ ] node tools/tests/test_memory.js 增加换档断言并全绿
四条格式很关键,缺一条子代理就会自己发明:
What to build 写成「合进去之后用户能看见什么」,不写成「改哪些文件」(文件归属另有施工约定);
Blocked by 只写票号,机器和人都能读,整张图就是从这些行拼出来的;
Status 让「谁能开工」变成查表而不是讨论;
勾选项 全是可判定的行为,没有一条是「代码质量好」这种没法定案的话。
不是「代码分层」也不是「工作量平均」,而是两条:能单独合入,且合入后立刻可验证。按这个判据,01 必须包含「随机抽 10 对、能翻牌、能配对、计步计时」整条纵切——它一张票就穿过了数据、状态、界面三层,但它是唯一一张「能让用户玩起来」的票,所以它第一。
实施:九个步骤把「任务图」变成一堆子代理
implement-spec — 集成分支 + worktree + 前沿并发(内部调 tdd)
到这一步,活儿其实已经不是「写代码」,而是「调度」。implement-spec 的九步里没有一步在讲怎么实现,全在讲怎么让好几个子代理互不碍事:开集成分支、把每张票丢进自己的 worktree、合完一张就重算前沿、全部合完才让评审进场。
3. 建集成分支。若追踪器以 PR 关闭工作,或用户要求,则在第 5 步首次合并后开 draft PR
   (尚未领先 main 的分支开不了 PR),标记为关闭此规格与这些票。
4. 用 implementer 子代理实现每张票,每票在自己的 worktree、自己的分支上。每个 implementer:
   · 开工前确认自己的 worktree 基于集成分支,若不是就 reset 到它上面;
   · 调 Skill 工具跑 tdd 把票建起来;
   · 报完成之前先把集成分支的 tip 合进自己的分支。
5. 每个 implementer 完成后,用 merger 子代理把它合进集成分支。
6. 若前沿变了,就再派一批 implementer —— 这是并发度的来源。
7. 全部完成后,在集成分支上跑 code-review,把问题交给一个 implementer 一次修完。
8. 若有 draft PR,就把它标成 ready;否则按追踪器的规矩逐张关票。
9. 清理所有 implementer 的 worktree。

沟通要稀疏。主要靠上下文指针:指向规格、票、调研笔记、之前的提交。不要转述已经能查到的东西。
最后那段话是整个流程能跑起来的真正原因。派出去的每个子代理看不到主线程的对话,所以任务书里不是「我们刚才讨论了…」,而是一串路径:读 SPEC.md、读 issues/02-*.md、读施工约定 ARCH.md。主线程花在转述上的 token 越少,能同时带多少个子代理就越多。
5.1第一颗子弹:一张票就让它能玩
票 01 的目标不是「搭好架子」,而是「能玩」:随机抽十对、能翻、能配、计步计时。它在自己的一条分支上完成,提交时新增五个文件:
kana-memory/game.js        110 行   纯逻辑:洗牌 / 开一局 / 翻一张 / 结算
kana-memory/page.js        329 行   接线:建牌 / 绑事件 / 渲染计数 / 档位注册
kana-memory/index.html      58 行   插槽 + 固定脚本顺序
kana-memory/kana.css       131 行   纸感卡片墙(照样张 B)
tools/tests/test_memory.js 430 行   116 项断言,DOM 桩驱动真页面
 tools/test.mjs              1 行   登记进 SUITES
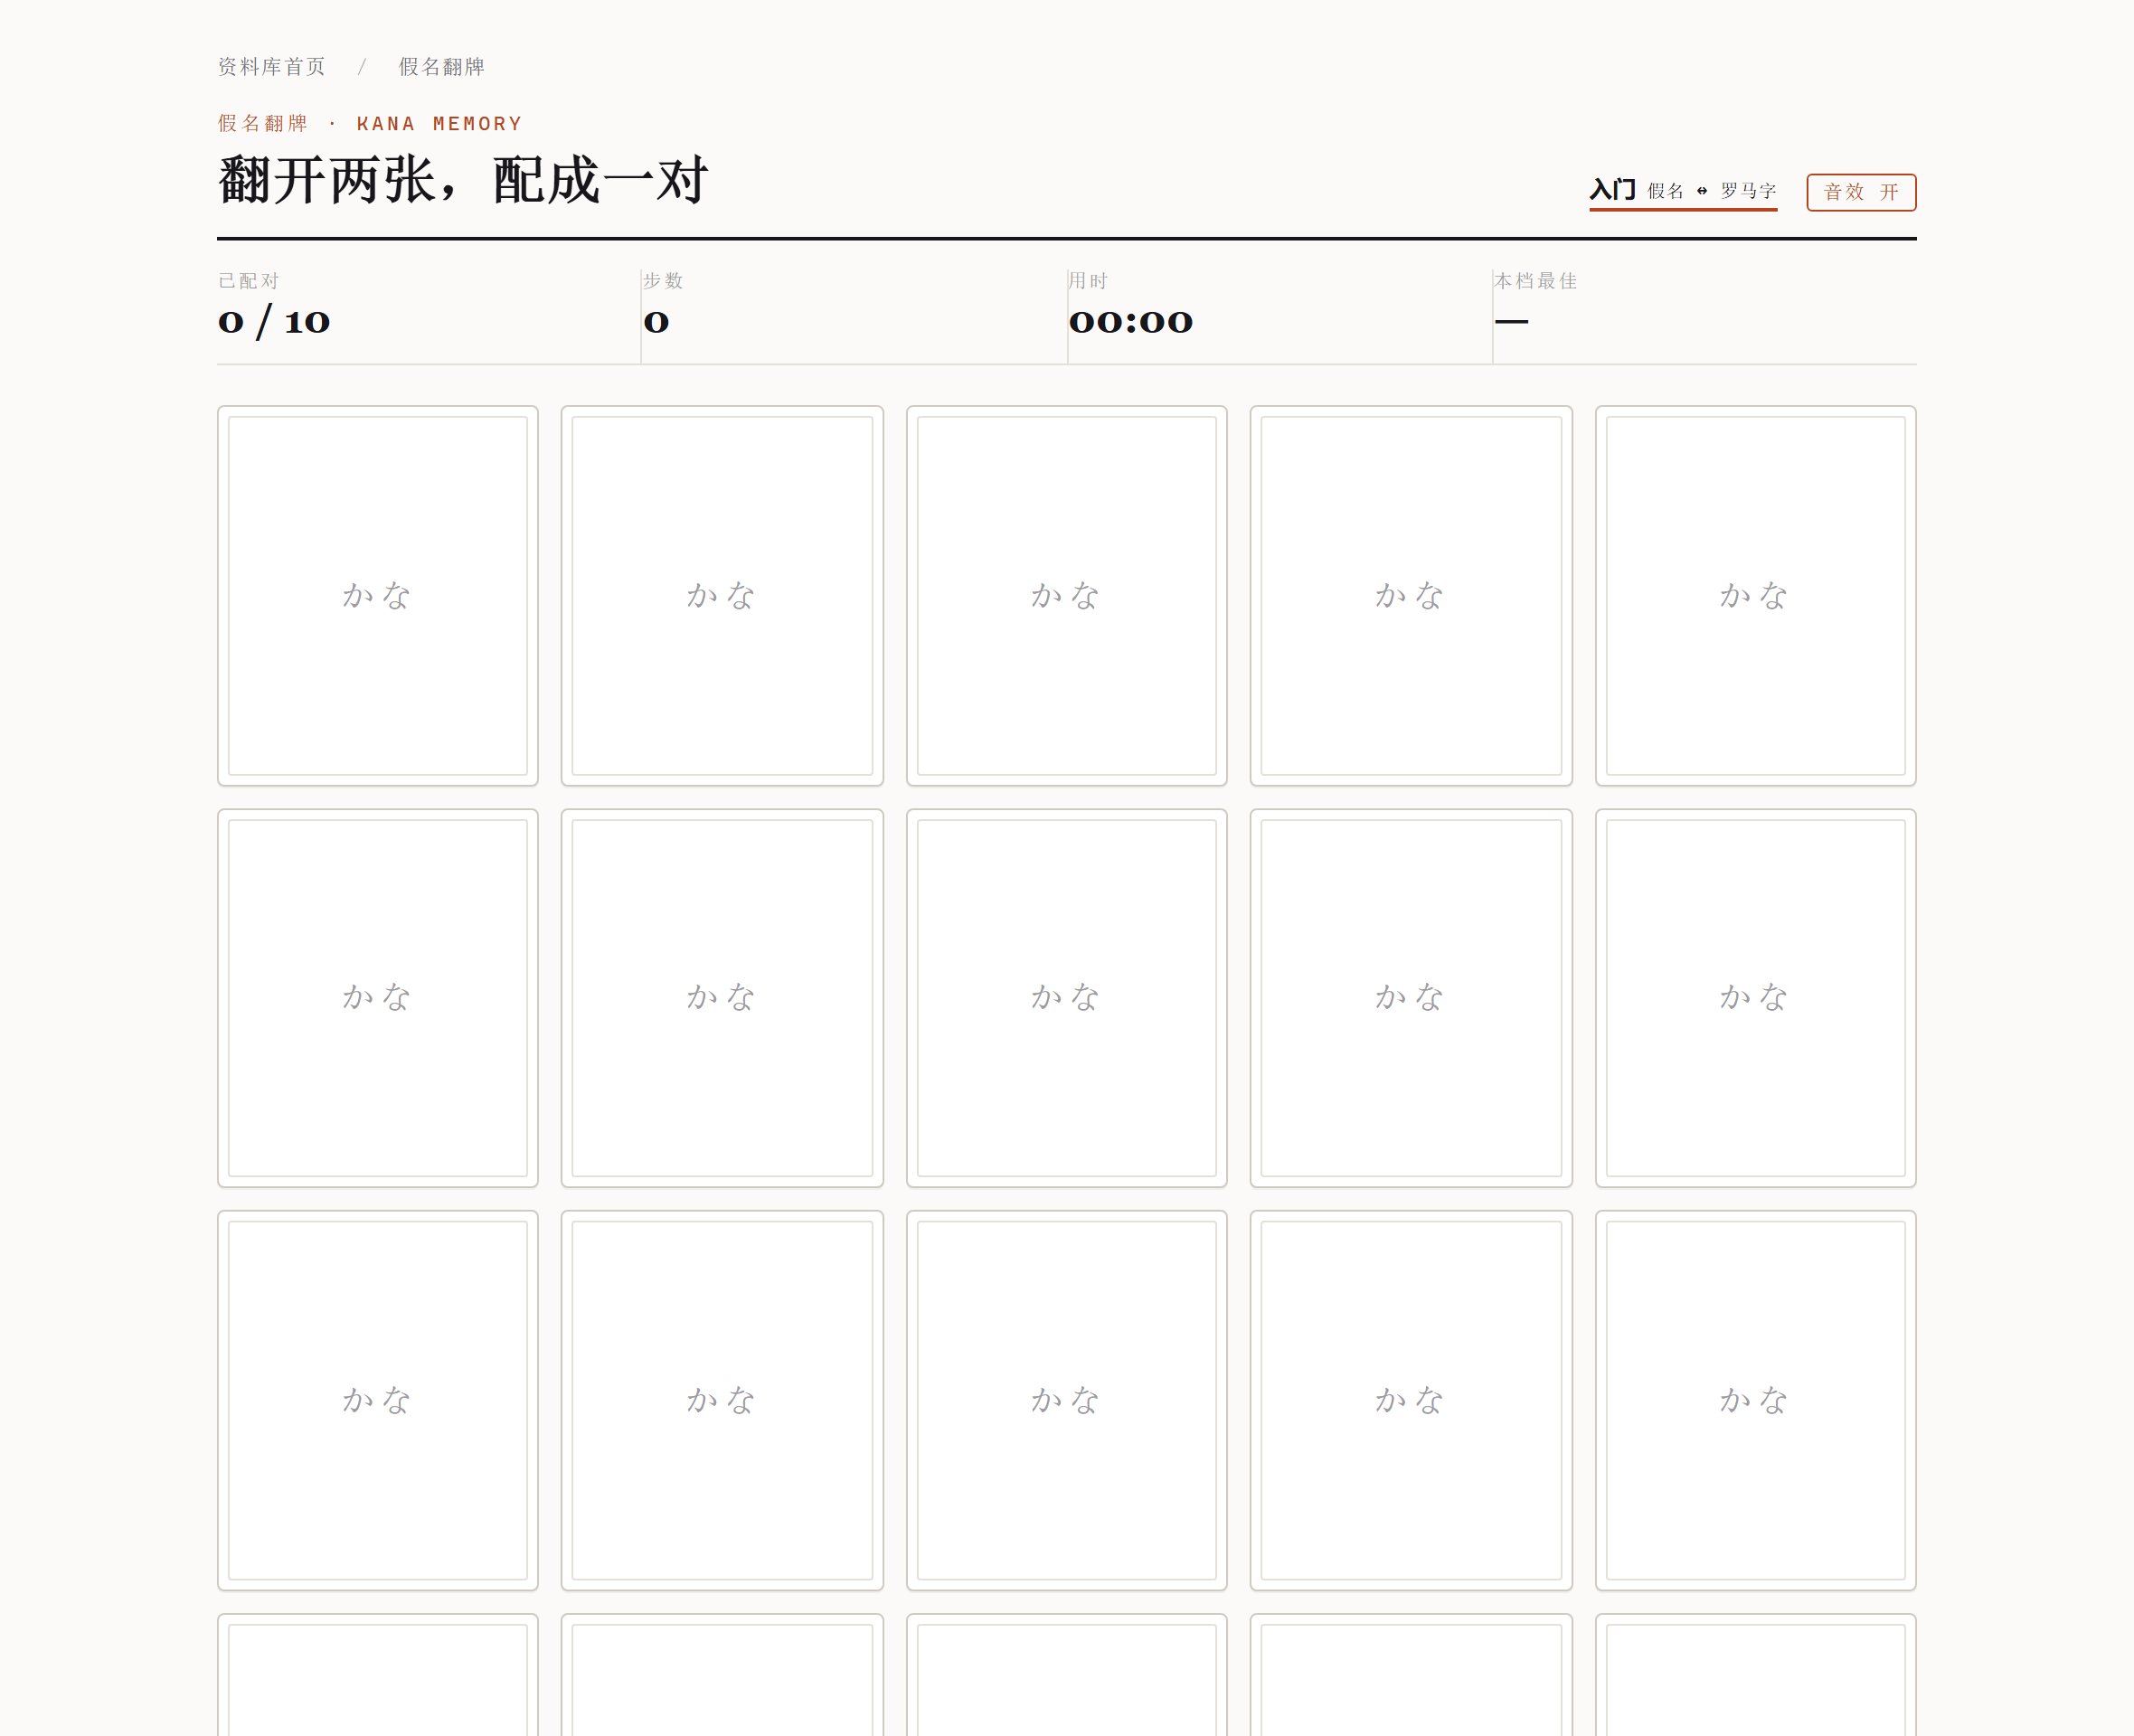
注意这一版「不完整」得刚刚好:档位只有一个、最高分列显示破折号、结算条是空的、音效按钮点了没反应。但它已经能玩一局,所以它是可以被验证的——这也是为什么切票时要它先落地,而不是先把三个档位写完。
5.2每个 implementer 开工的第一件事:先写会红的测试
implement-spec 让每个 implementer 「调 Skill 工具跑 tdd」,不是为了仪式感,而是为了不让子代理把测试写成「跑得通就行」。tdd 里真正有用的不是红绿循环本身,是它规定的什么算好测试:只断言外部可观察行为,不断言样式、不测动画时长、不测音频波形。
| 风险(真实存在) | 测试怎么捉它 |
|---|---|
| 洗牌写错,牌墙出现两张一模一样的牌 | 断言「一局里每对恰好两张、无重复无遗漏」—— 这条是从样张阶段的真实事情留下的 |
| 配错后不翻回去 | 推进假定时器到 619ms 仍开着,到 620ms 回背面 |
| 同一张牌被点两次计入步数 | 点两次,断言步数不变、状态不变 |
| 换档后旧定时器把新牌局改乱 | 换档后推进旧定时器,断言新牌局不受影响(代际守卫) |
票 01 交上来的时候测试数字是 ✓ 全部通过 (116),全仓 node tools/test.mjs 是 26 通过 · 0 失败 · 9 跳过 · 2432 项断言。那 9 个跳过不是失败——是需要本地源材料或密钥的套件,在别人克隆的仓库里本来就不该跑。
5.3开二条线:并行写入的边界在哪
票 01 合进集成分支后,前沿变成两张票(02 和 04),于是同时派两个子代理,各自一个 worktree、自己的分支:
library           0253041 [feat/kana-memory]   ← 集成分支,只有它往 main 上合
library-wt/01     3823508 [feat/kana-01]       ← 已合并,留作对照
library-wt/02     0253041 [feat/kana-02]       ← 进阶档 + 档位切换(进行中)
library-wt/04     0253041 [feat/kana-04]       ← 手感与可达性(并行)
并行的真正约束不是 CPU,是文件归属。两个子代理同时改一行,合并时就只能手工猜。所以派活时先写一张归属表:谁拥有 kana.css、谁拥有 page.js、谁的测试文件只归谁。这张表还提前把冲突点写成了规则——「02 只能往 page.js 加两处,上限 8 行」,而不是「你们小心点」。
5.4两条线撞在一起:冲突的解法不能靠「看哪边新」
票 04 交上来合并时报了两处冲突,都是并行写入的必然产物,不是谁的错:
CONFLICT (content): Merge conflict in kana-memory/index.html
CONFLICT (content): Merge conflict in tools/test.mjs

kana-memory/index.html 的脚本块:
<<< 集成分支(票 02 刚加的)
  <script src="../typing/data/n5.js"></script>
  <script src="../typing/data/n4.js"></script>
  <script src="tiers.js"></script>
=== 票 04 的分支
  <script src="feel.js"></script>
>>> feat/kana-04
低级的解法是「两边都留」——那么 feel.js 会排到 tiers.js 前面还是后面,完全取决于编辑器把哪块放在上面。真正的解法在施工约定里:脚本顺序是**契约**,写死成 romaji → game → n5 → n4 → tiers → score → feel → page。合并时按契约重排,而不是按提交时间或代码块位置。
tools/test.mjs 的冲突同理:两边各往 SUITES 里加了一行测试套件,两行都保留、按契约里的顺序排——一行是「进阶档 / 换档」,一行是「手感与可达性」。
这次合并完整跑了一遍三个套件(118 + 80 + 89 项断言)之后才提交。合并提交的职责不是「让 git 不报错」,是让两条线的语义都还在。
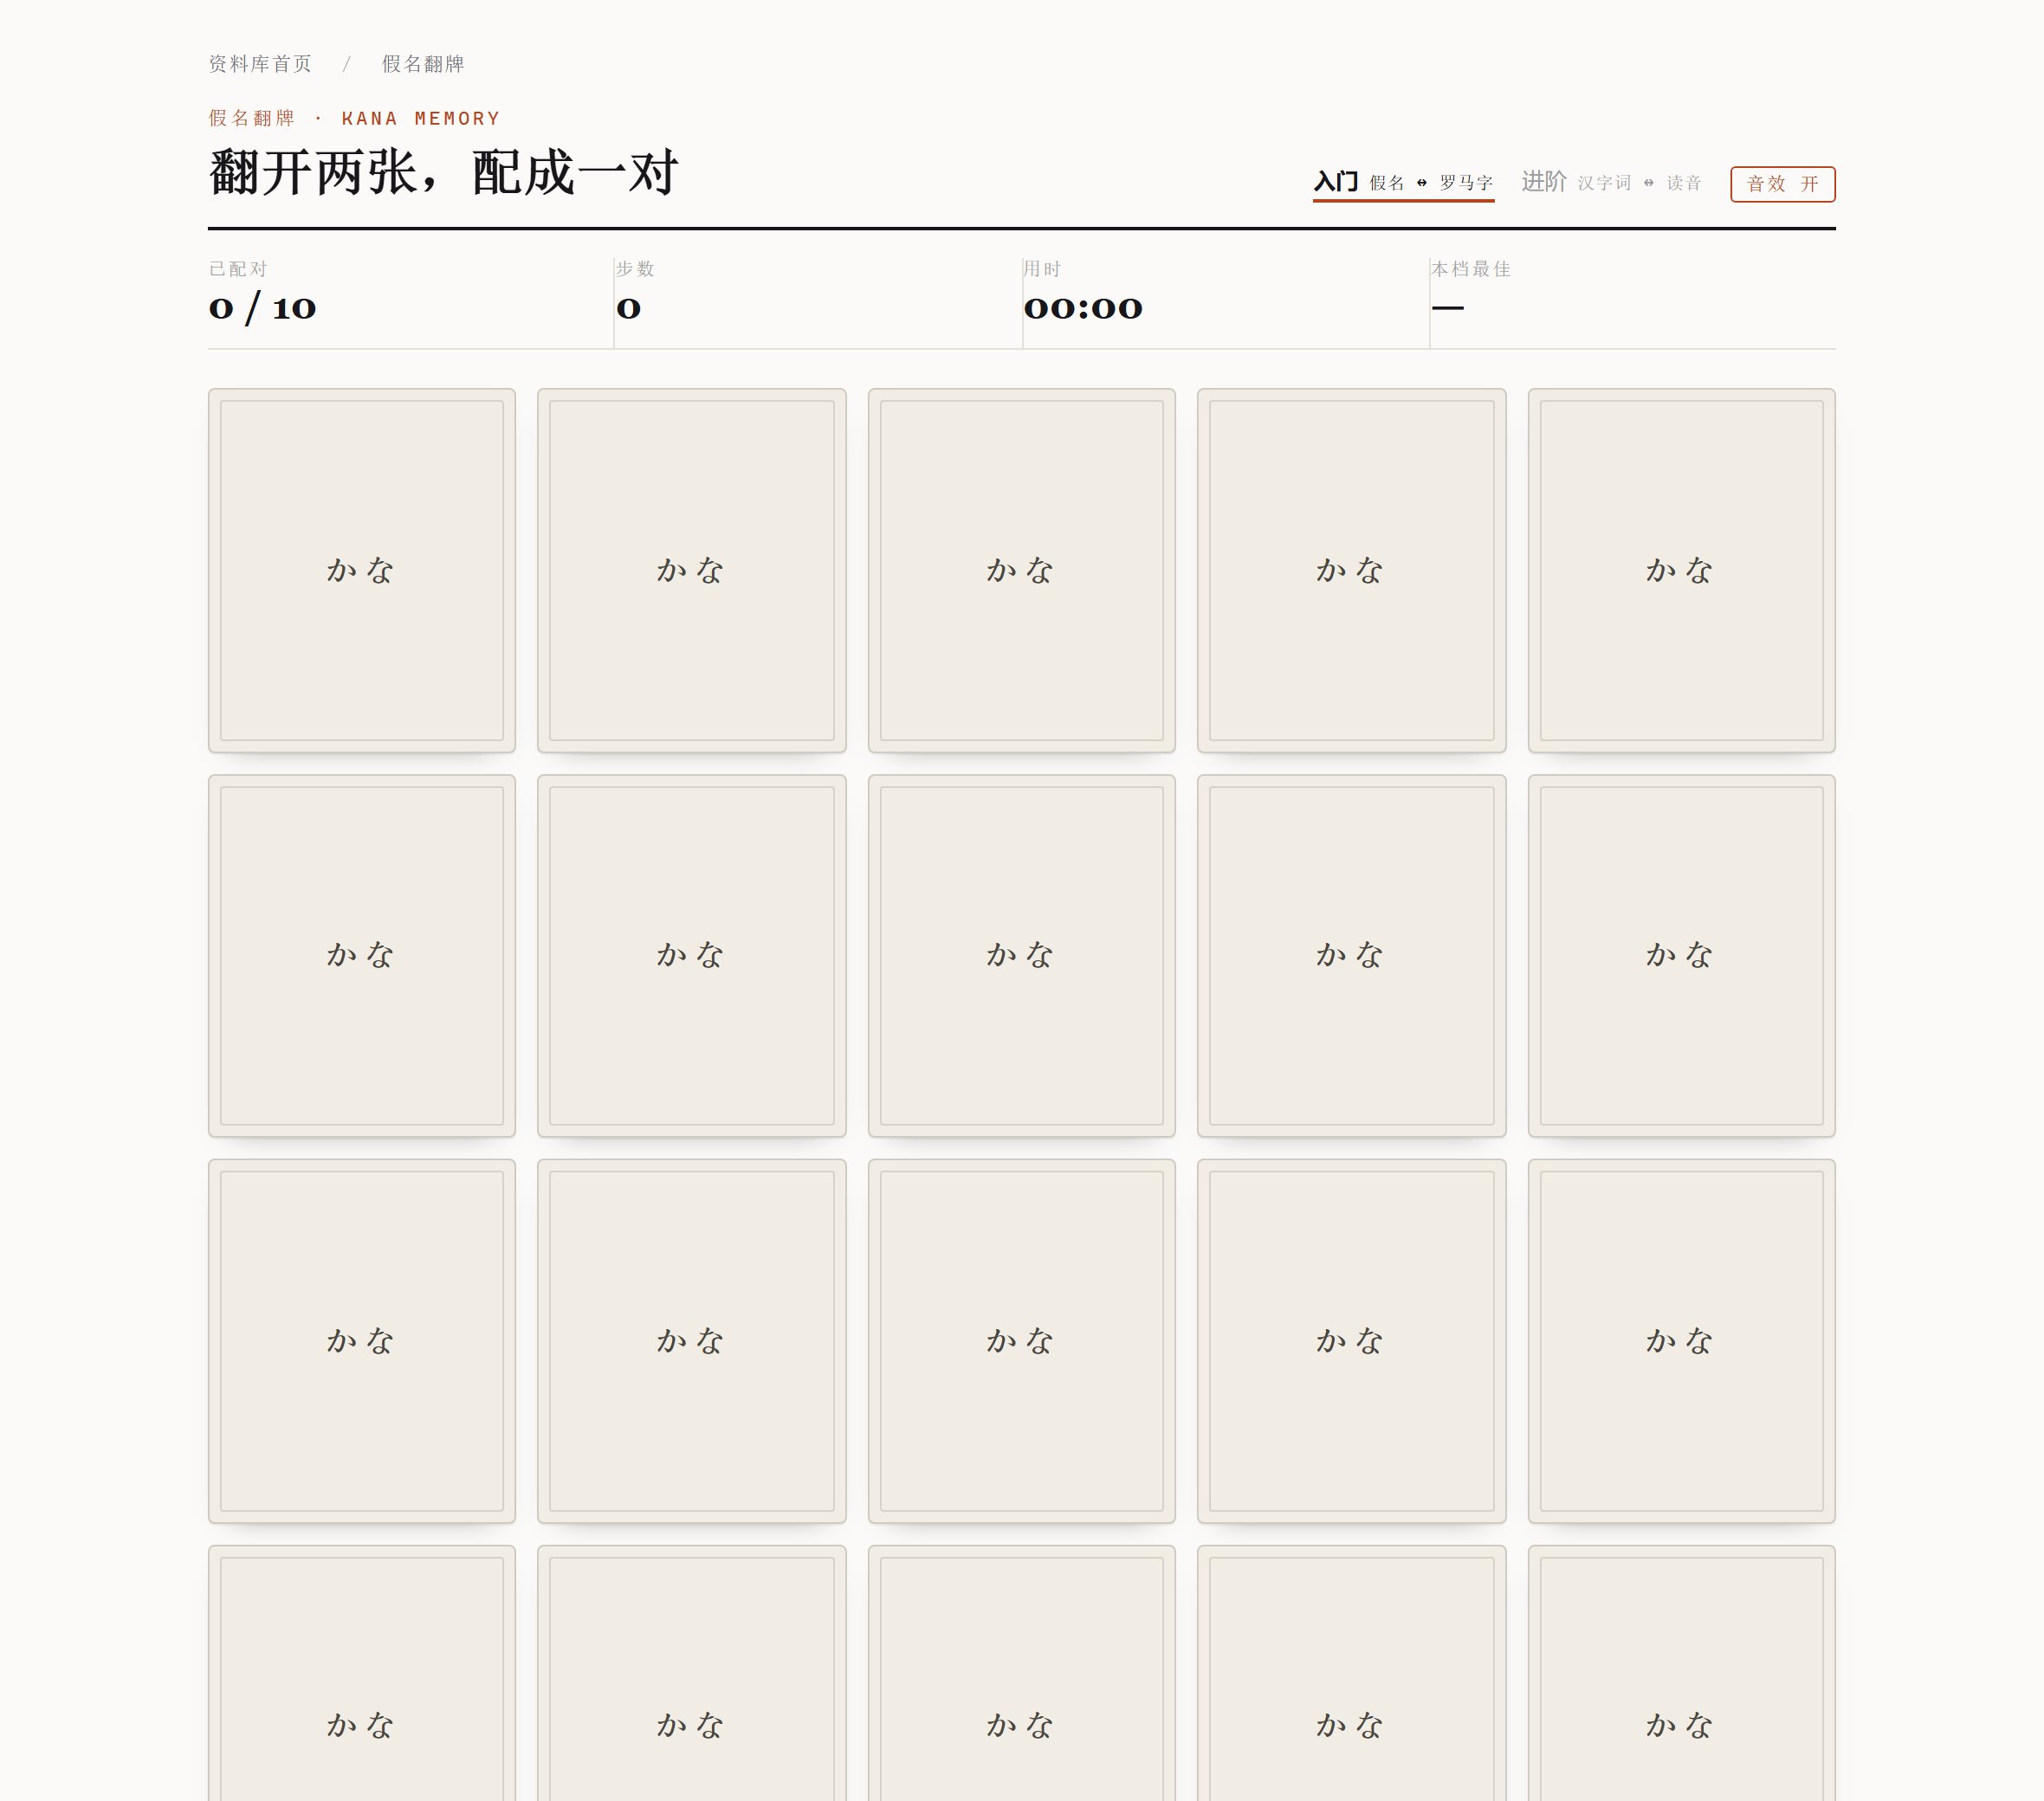
かな 从 1.9:1 拉到 7.3:1,牌墙终于像一面墙;同一屏里能看到三档 tab 都出来了。这张图值得和票 01 那张并排看:同一条命令、同一个视口、同一个页面,中间只隔了一次「按截图改」——任务书里附的是那张截图,不是「请提高对比度」这样的形容词。子代理拿到的是可核对的差,改完也能自证改到了。
5.5守卫到期:子代理第二次停下来问
票 03 干到最后卡在一行测试上。集成分支里有一条断言是票 01 写的:
/* 02/04 各自把自己那行 script 加进来时不必改这条:只禁还没实现的 score.js(票 03) */
ok(!/<script[^>]*src="score\.js"/.test(html), 'score.js(票 03)还没被提前引用');
票 03 正是那个要让 score.js 存在的票。它一旦按 ARCH 加那行 <script src="score.js">,这条断言必红;而任务书同时写着「不许改 test_memory.js」「test_memory.js 必须全绿」。三件事不可能同时成立。
它没有选最省事的那条路。它停下来,把冲突摆出来,给了三种解法,并附上建议的那一种——而且指出同一文件里紧邻的两行已经是同构的正向写法(「若引了 tiers.js,它要排在 page.js 之前」)。
这条断言的本意是「别提前引还没落地的东西」——它天生要被落地那一票翻面。所以批准不是「把测试改绿」,而是承认守卫到期了:判据写死成一句话——谁来落地这个文件,谁就负责把它从「还不存在」改成「若存在,必须在某两个脚本之间」。改动范围只有那两行,其余 117 项一个字不动。
这是同一个模式第二次出现(票 02 那次是「不许引 tiers/score/feel」的断言,同样由落地票翻面)。两次都不是流程出错,而是守卫的生命周期:写守卫的人知道它会在哪一票到期,就把到期条件写在注释里;到期那一票的负责人翻面,翻面要同构、要窄。子代理两次都停下来的行为,比它改对更难教——所以 ARCH 里现在有一句明文:规矩互相矛盾时停下来问,不要自己扩范围。
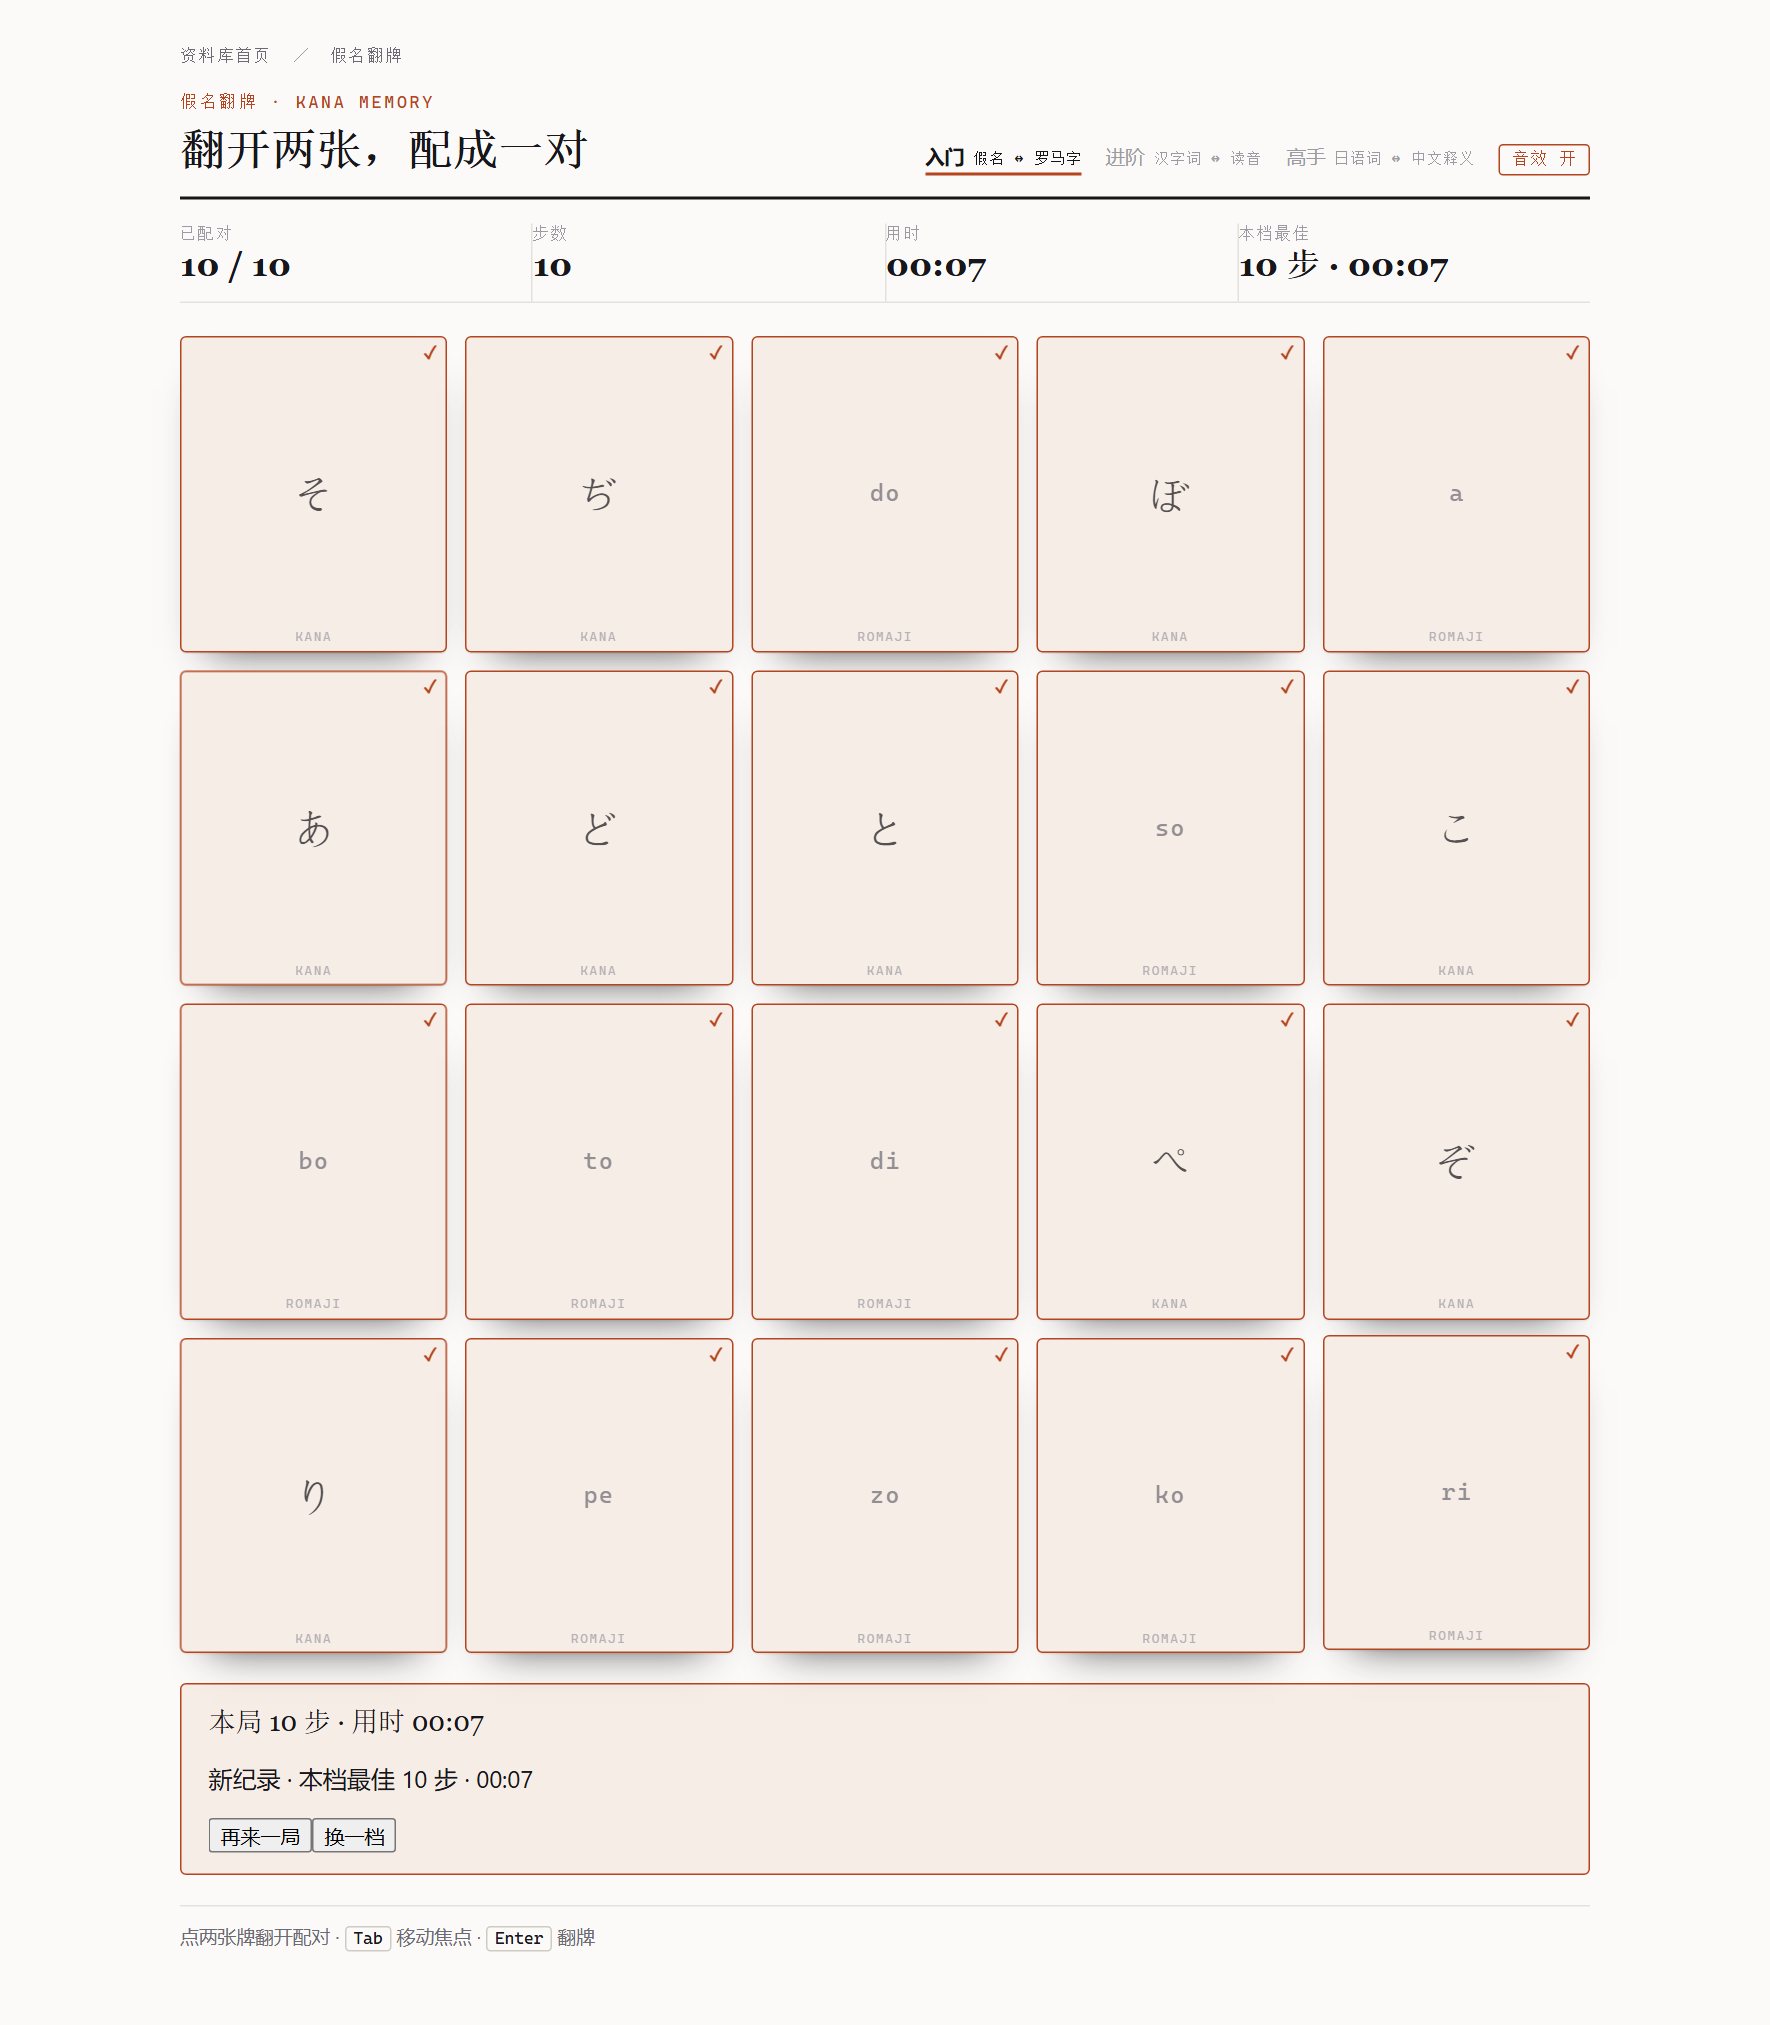
票 03 交上来的东西:score.js 234 行(高手档 + 每档最高分 + 结算条)、test_memory_score.js 551 行 / 139 项断言。两处自定的判断值得记:
- 牌面小标签取
{ a: 'ことば', b: '中文' }。a 面是「读音(附汉字写法)」,叫「読み」盖不住括号里的汉字,叫「ことば」才覆盖整面;b 面是释义,对日语读者不是读法而是意思,就不复用进阶档的「読み」。 - 这一档的
m有 11 个重复值、100 条m与某个w字面相同,所以占位集合必须同时记 a、b 两面——只记一边会发出一局**没有唯一解**的牌墙。
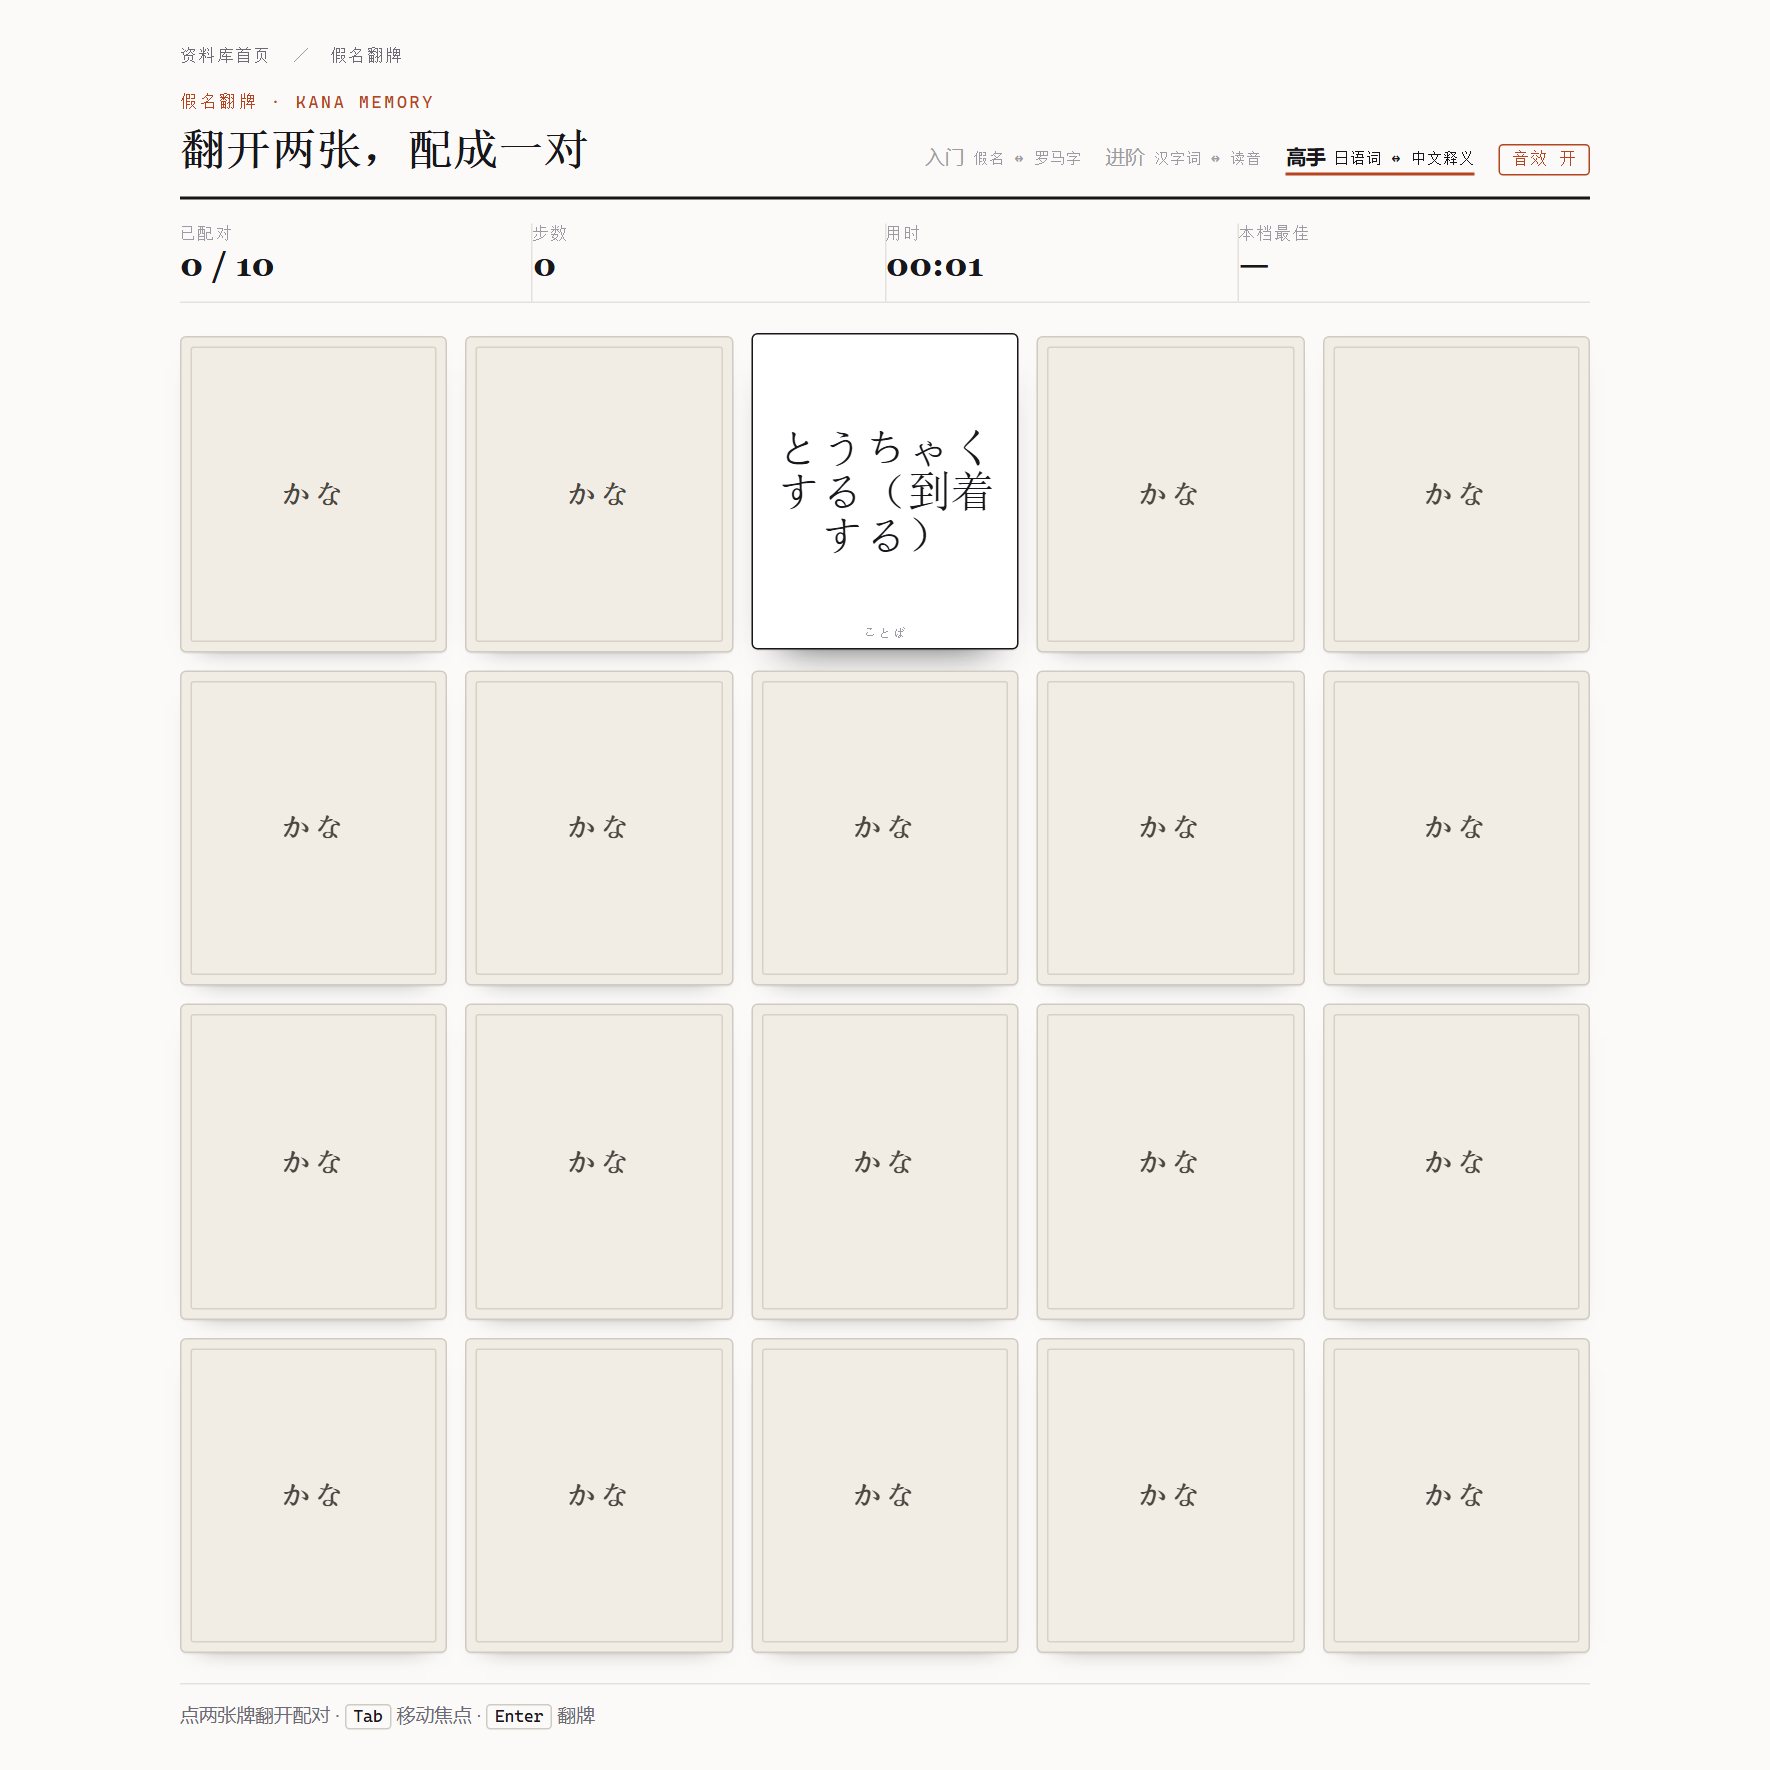
せんもんがっこう(専門学校))、13 字以上共 43 条;牌面 white-space:normal 在字间折行,两行放下——这张是 10 字的 えいがかん(映画館)。结算条是这一票的收尾:本局步数、用时、是否刷新该档纪录,加「再来一局」「换一档」两个出口,出现后牌面不可再翻。设计上最要紧的一条是纪录按档分开记——入门档 10 步满分和高手档 10 步不是一个东西,混在一个键里,进阶难度就没意义了。
票 02 开工五分钟就停下来问了三个阻断点,其中一个很典型:施工约定要求它自己的脚本注册到「档位表」,但那个表要到 page.js 末尾才存在,而 boot() 就在后面一行——于是刷新页面时保存的「进阶档」会被回落成「入门档」。它给了三个方案(改两行 / 加一行守卫 / 一行不改但靠内部实现细节),并说明推荐哪个、为什么不推荐第三个。
这是并行开发里最值得期待的场景:子代理不能自己改契约,但必须把冲突升级上来,而且带着方案。最后选了第一个方案——允许它改 page.js 六行,同时由主线程把施工约定回写一份:契约改了,文档必须同批改,否则下一个子代理会拿着旧约定开干。
5.6最后一张票最轻,却最容易踩人
05 的活儿看着最没技术含量:门户加一张卡、写一份 ADR、补两处文档。它踩到的全是别人早写死的数字——三处测试各写了一遍「语言学习区有 12 张卡」(test_area.js:48、test_reading.js:283、test_typing_en.js:380),加一张卡就得改三遍;谁忘了改,测试红在同一句看不懂的话上。
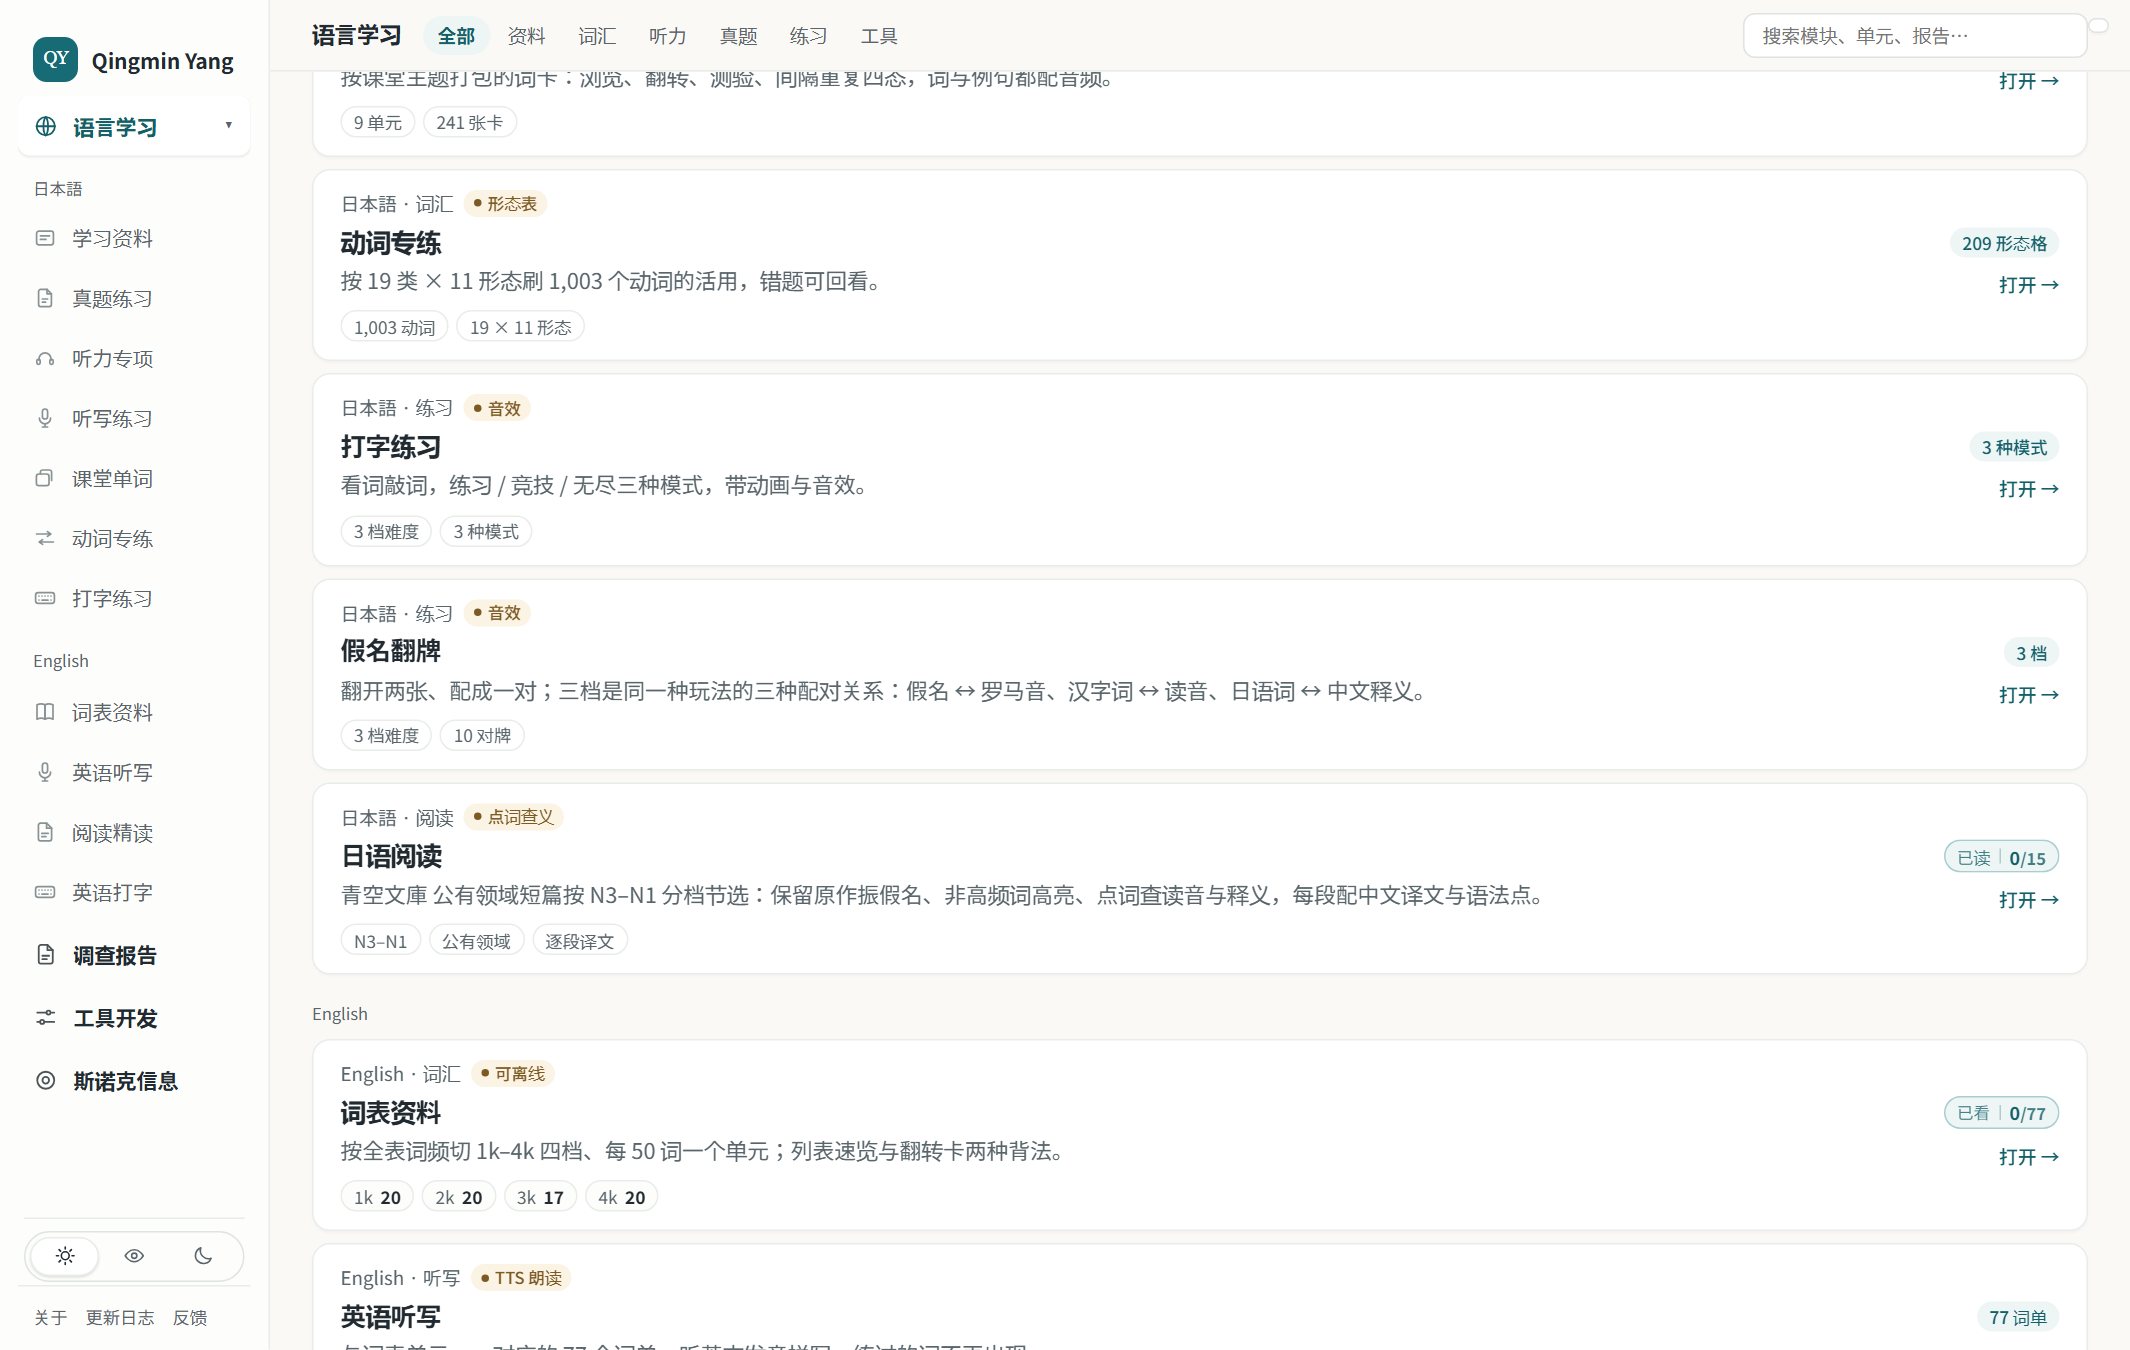
data-tags="词汇 练习" 决定它被哪些筛选项命中;pill 写「音效」是因为声音是这台设备上合成出来的,不需要耳机文件;卡片故意不带 data-en-key——全页必须恰好 107 项那条门禁就靠这一点不被误伤。它顺手处理了一个更麻烦的东西:ARCH 里写的「给新页加 rail」并不该做。这个页面为了自成一格,没有引 assets/style.css,而 rail.mjs 的规则是「引了共享样式才必须有 rail」——照着 ARCH 去加,反而会破另一条先例(typing/ 就是这么自成一格的)。
这类偏差最容易被当成「漏做」。判据是:哪一边的先例更硬。这里是先例更硬(同仓已有两个模块不引共享样式),所以正确动作是让 ADR 把「为什么不加 rail」写下来,而不是硬加一个 rail 让它跟 typing/ 长得不一样。docs/adr/0013-kana-memory-module.md 就记了这一条,顺带解决了 ADR 编号被 0012 占掉的撞车。
评审:两个轴,故意不合并
code-review — 标准轴 · 规格轴 · 并行两个子代理
code-review 的全部主张就一句话:一次评审只能回答一个问题。所以它把评审劈成两个轴,各派一个子代理,拿回两份报告,并排放着——不合并、不重新排序、不选出「最重要的一条」。
标准轴  git diff main...HEAD 里的每个 hunk,违反仓库写明的哪条规矩?
        外加一份「坏味道基线」(Fowler 《重构》第 3 章),仓库有文档就以文档为准。

规格轴  同样一份 diff,对照 SPEC:哪些要求漏了 / 只做了一半?
        哪些行为规格根本没要(scope creep)?哪些看着做了但做法是错的?

代码合乎所有规范,但做错了事 → 标准轴过,规格轴红。
代码完全照规格做,但破坏了项目约定 → 规格轴过,标准轴红。
这个设计要挡住的是**掩盖**:如果一份 diff 的格式问题很明显,一次「什么都看」的评审就会把整篇篇幅花在格式上,规格偏差藏在最后一行;反过来,一个人拿着 SPEC 逐条对账,就会对重复代码和神秘命名视而不见。分开跑,两种漏法都堵住了。
$ git rev-parse main          # 固定点必须先解得出
7ff91f6c3c0b2a8eccbf8a1c67a6d1a0b9f2a7d5

$ git log main..HEAD --oneline
e245b58 feat(kana-memory): 合并票 04(手感与可达性)
28268ac feat(kana-memory): 合并票 02(进阶档 + 档位切换)
0253041 feat(kana-memory): 合并票 01(一局能玩)
0c1dd7d test(kana-memory): 静态断言只禁 score.js…

$ git diff main...HEAD --stat
固定点用**三点** diff(main...HEAD),比较的是 main 与分支的 merge-base,不是 main 的尖端——否则你评审的东西里会混进别人这期间合进 main 的提交。skill 里还有一条前置检查:固定点解不出来、或者 diff 是空的,在这一步就失败,别等到两个并行子代理里才炸。
标准轴要什么,skill 说得很具体:找到仓库里每一份写「代码该怎么写」的文件(CODING_STANDARDS.md、CONTRIBUTING.md 存在就必须在列),再把那份坏味道基线原样贴进子代理的任务书——子代理的上下文是干净的,它看不到你手里的基线。本仓库的清单是四份:CODING_STANDARDS.md、AGENTS.md(架构约束与不变量)、docs/portal-map.md(真源→生成器→校验)、docs/adr/(已决架构,如 ADR-0011 要求新模块同批改四处)。
基线里的每一条都只是带标签的启发式(「可能是 Feature Envy」),永远不是硬违规;而仓库文档里写明的规矩可以是硬的。skill 还给了两条铁律:仓库文档覆盖基线(文档承认的做法,基线就别再挑),工具已经管的事不要报(格式、行尾、Lint 能查出来的,别浪费评审的篇幅)。
6.1 真跑一次:两个子代理,两份报告
任务书里各塞三样东西:固定点(git rev-parse main 解出来的那个 sha)、要读的文件清单、输出路径(.scratch/kana-memory/review/{standards,spec}.md)。两个都跑完、都读完,再动手改任何一行。
标准轴  硬违规 1  CONTEXT.md「模块」词条还写「十一张入口卡 / 日语侧七张」,
                  而同批 README.md 已经改成 13 张 —— 两份文档互相矛盾
          判断项 9  四个测试里逐字重复的 fakeTimer / loadPage(该抽进 dom.js)
                   wordPool、fmtMs、restart 三处重复
                   tiers.js 有「KanaApp 已存在」分支 / score.js 无条件 push
                   score.js 反查 DOM 只为取档位顺序(Feature Envy)
                   emit 挂进公开 API 但无调用者(Speculative Generality)
                   「一局 10 对」散在五处(Shotgun Surgery)
                   票号注释失真 8 处
                   反向断言:点 #k-sound 后仍断言 aria-pressed === 'true'
                   门户徽章「3 种模式」与正文「三档」串味

规格轴  P1      ≤640px 仍是 5 列,375px 下每张牌约 63px 宽、
                  正文区 49×60px,而字号是 21px —— 高手档 13 字的牌面
                  要排 7 行(约 147px),牌与牌直接互压
          P2      CONTEXT.md 缺「假名翻牌 / 档位 / 牌对 / 一局」
                  翻牌时 #k-live 播的那句与这张牌的 aria-label 同文(读屏念两遍)
                  结算条的 .k-btn / .k-result-* 造了但 kana.css 里没有规则
注意两轴的口径差别:标准轴把 CONTEXT.md 判成「硬违规」,因为它违反 AGENTS.md 里「术语唯一真源」这条写明的规矩;规格轴把同一件事判成 P2,因为它的依据是 SPEC 里「需要增补词条」的建议性表述。同一处毛病、两个轴、两种严重度——这就是 skill 坚持不合并两份报告的理由:并排放着,你来决定哪个标签算数。
规格轴那条 P1 值得单独说:它做的是拿尺子量——375px 屏、5 列、每张 63px、正文 49×60px、字号 21px、最长牌面 13 字,算出来要 7 行。这种结论代码里看不出来,只能算。我复核时用 playwright 把页面压到 375px 一量,scrollHeight - clientHeight 是 18~28px,跟它算的方向一致。
6.2 修补:一次提交,逐条对上
评审本身不改代码。改代码的是「读完两份报告的人」——也就是我。我挑了自己认的(硬违规 + P1 + 三条便宜的 P2),聚成一个提交 52bf5e4,每条在提交说明里对上评审原文。
kana.css      窄屏 5 列 → 4 列 + .k-word{font-size:clamp(12px,3.1vw,19px)}
              .k-face{overflow:hidden} · .k-tile{aspect-ratio:1/1.12}
              补 .k-result-record / .k-result-actions / .k-btn / .k-btn--primary
page.js       删掉翻牌时那次 announce(tileLabel(...))     aria-label 已经念过同一句
score.js      「再来一局」加 k-btn--primary
test_memory.js  #k-sound 那条反向断言改成只验形状
              type=button + aria-pressed ∈ {true,false},真值由 test_memory_feel.js 覆盖
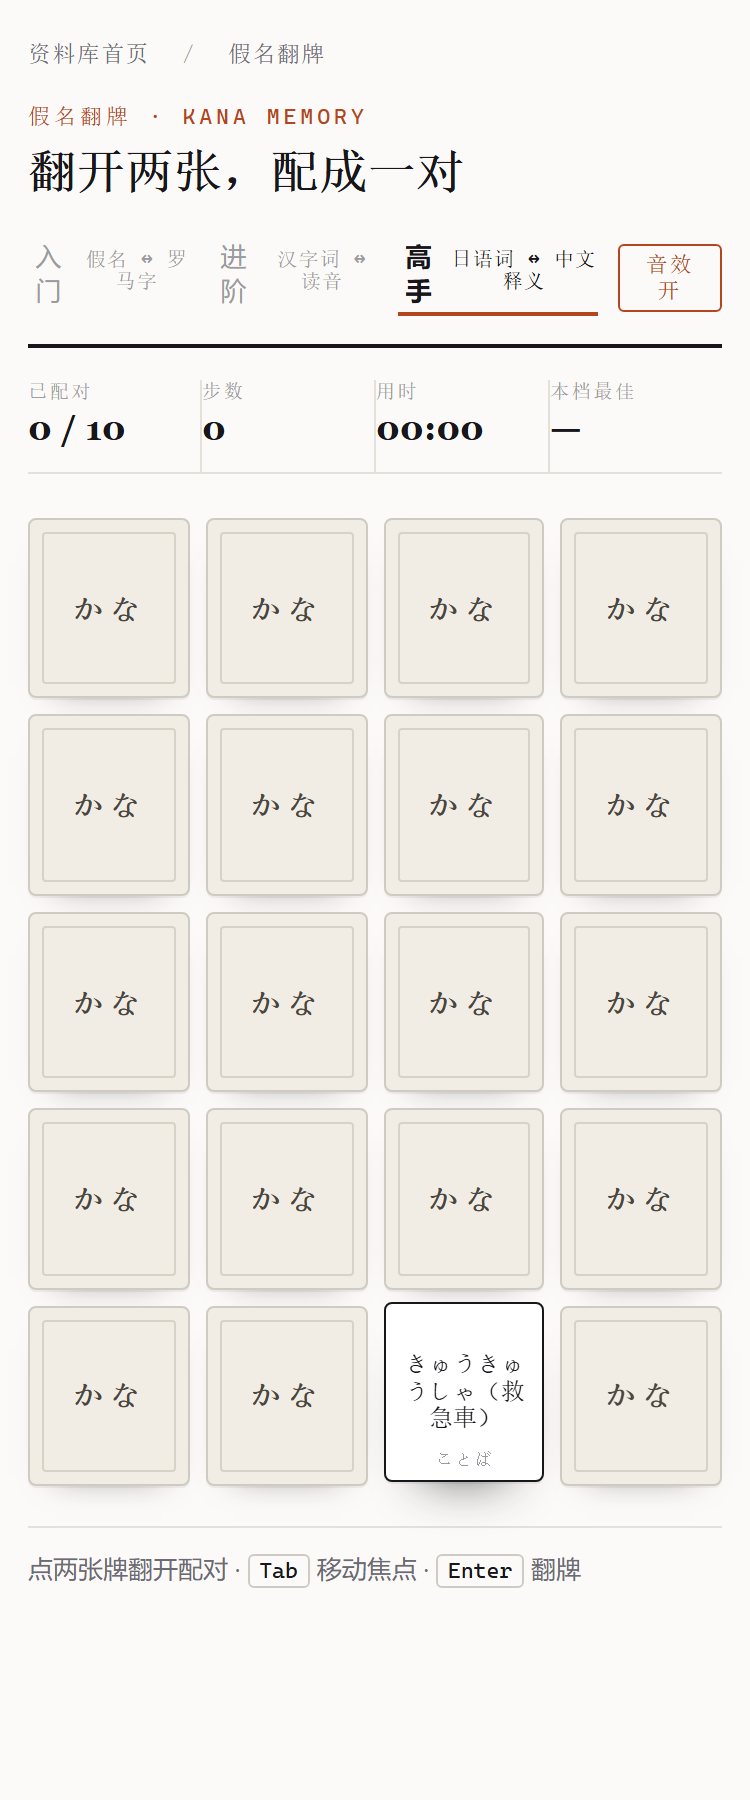
grid-template-columns 算出 4 列、每张 81px、最长牌面 13 字不溢出(scrollHeight - clientHeight = 0)。修之前这一格是 18~28px 的溢出。四条里有一条要承认是没修的:重复的 fakeTimer / loadPage / wordPool / fmtMs。抽出去要同时动四个套件和 tools/tests/dom.js,评审之后、PR 之前的窗口里,这属于「改动面积大于收益」。我把它记进 retro 的「欠账」,让下一轮开票时有据可查——评审报告的价值不在于每条都被修,而在于每条都被记录且被分过类。
那条硬违规的现场(CONTEXT.md)根本不在 diff 里——它被 .gitignore 排除,只在本机存在。搜索规格轴也一样,它翻的是「术语真源」这份文档本身。这条差点被我判成误报:我改完 CONTEXT.md 想提交,git add 直接回「该路径被忽略」。结论是改名与词条这类「本机真相」类文档,只能靠评审去对,机械校验永远看不见它。
交付:PR 正文只回答三个问题
pr — 图说改动 · 前后证据 · 合并风险
pr 这个 skill 只有一段模板和一句劝告:跳过一切前言,只留下能回答问题的部分。模板三段,各有各的读者:Summary 给想知道「改了什么形状」的人,Evidence 给不信「能跑」的人,Merge Danger 给要按合并键的人。
## Summary
<diagram, diff-sketch, or tree>

## Evidence
- **Before:** <screenshot/output/failing test run>
  **After:** <screenshot/output/passing test run>

## Merge Danger
**Door:** <one-way or two-way>
**Blast Radius:** <one-word description>
三段里最容易被写坏的是第一段。Summary 不是「改了哪些文件」的清单,而是一张能让人一眼看懂形状的图:改逻辑就给伪代码,改控制流就给调用树,改文件归属就给浅树,改界面就给组件树或 diff。本案例的改动正好是「多了一整块目录 + 门户上多一张卡」,所以用浅文件树 + 一段 diff:树说清新模块由谁负责,diff 说清既有结构里多了什么——两样都比三段文字快。
第三段是最少人写、最该写的一段。「单向门还是双向门」这个问题逼你想一件事:合下去之后好不好退。新目录 + 一张门户卡 + 四处断言数字,一个 revert 就回去了,是双向门;但「三处断言与新卡是同批改的」这条要写出来——只回退一半,门户测试会红。
implement-spec 第 3 步说得很具体:首次合并之后再开 draft PR——因为一个还没领先 main 的分支连 PR 都开不出来。这条不是形式主义:有了 PR,后面每合一张票,评审者看到的是一个在长的东西,而不是最后一坨。
$ git push -u origin feat/kana-memory
 * [new branch]      feat/kana-memory -> feat/kana-memory

$ HTTPS_PROXY=$PROXY gh pr create --draft --base main --head feat/kana-memory     --title "假名翻牌:一个新的顶级练习模块" --body-file .scratch/kana-memory/pr-draft.md
https://github.com/Yang-Code01/jlpt-library/pull/40
PR 正文的定稿不在这时候写。draft 阶段它只需要两件事:说清这是什么、勾出票的进度——让人知道现在看它有没有意义。真正的正文留到 code-review 之后,用 pr 的模板重写一遍,然后 gh pr edit 覆盖上去。
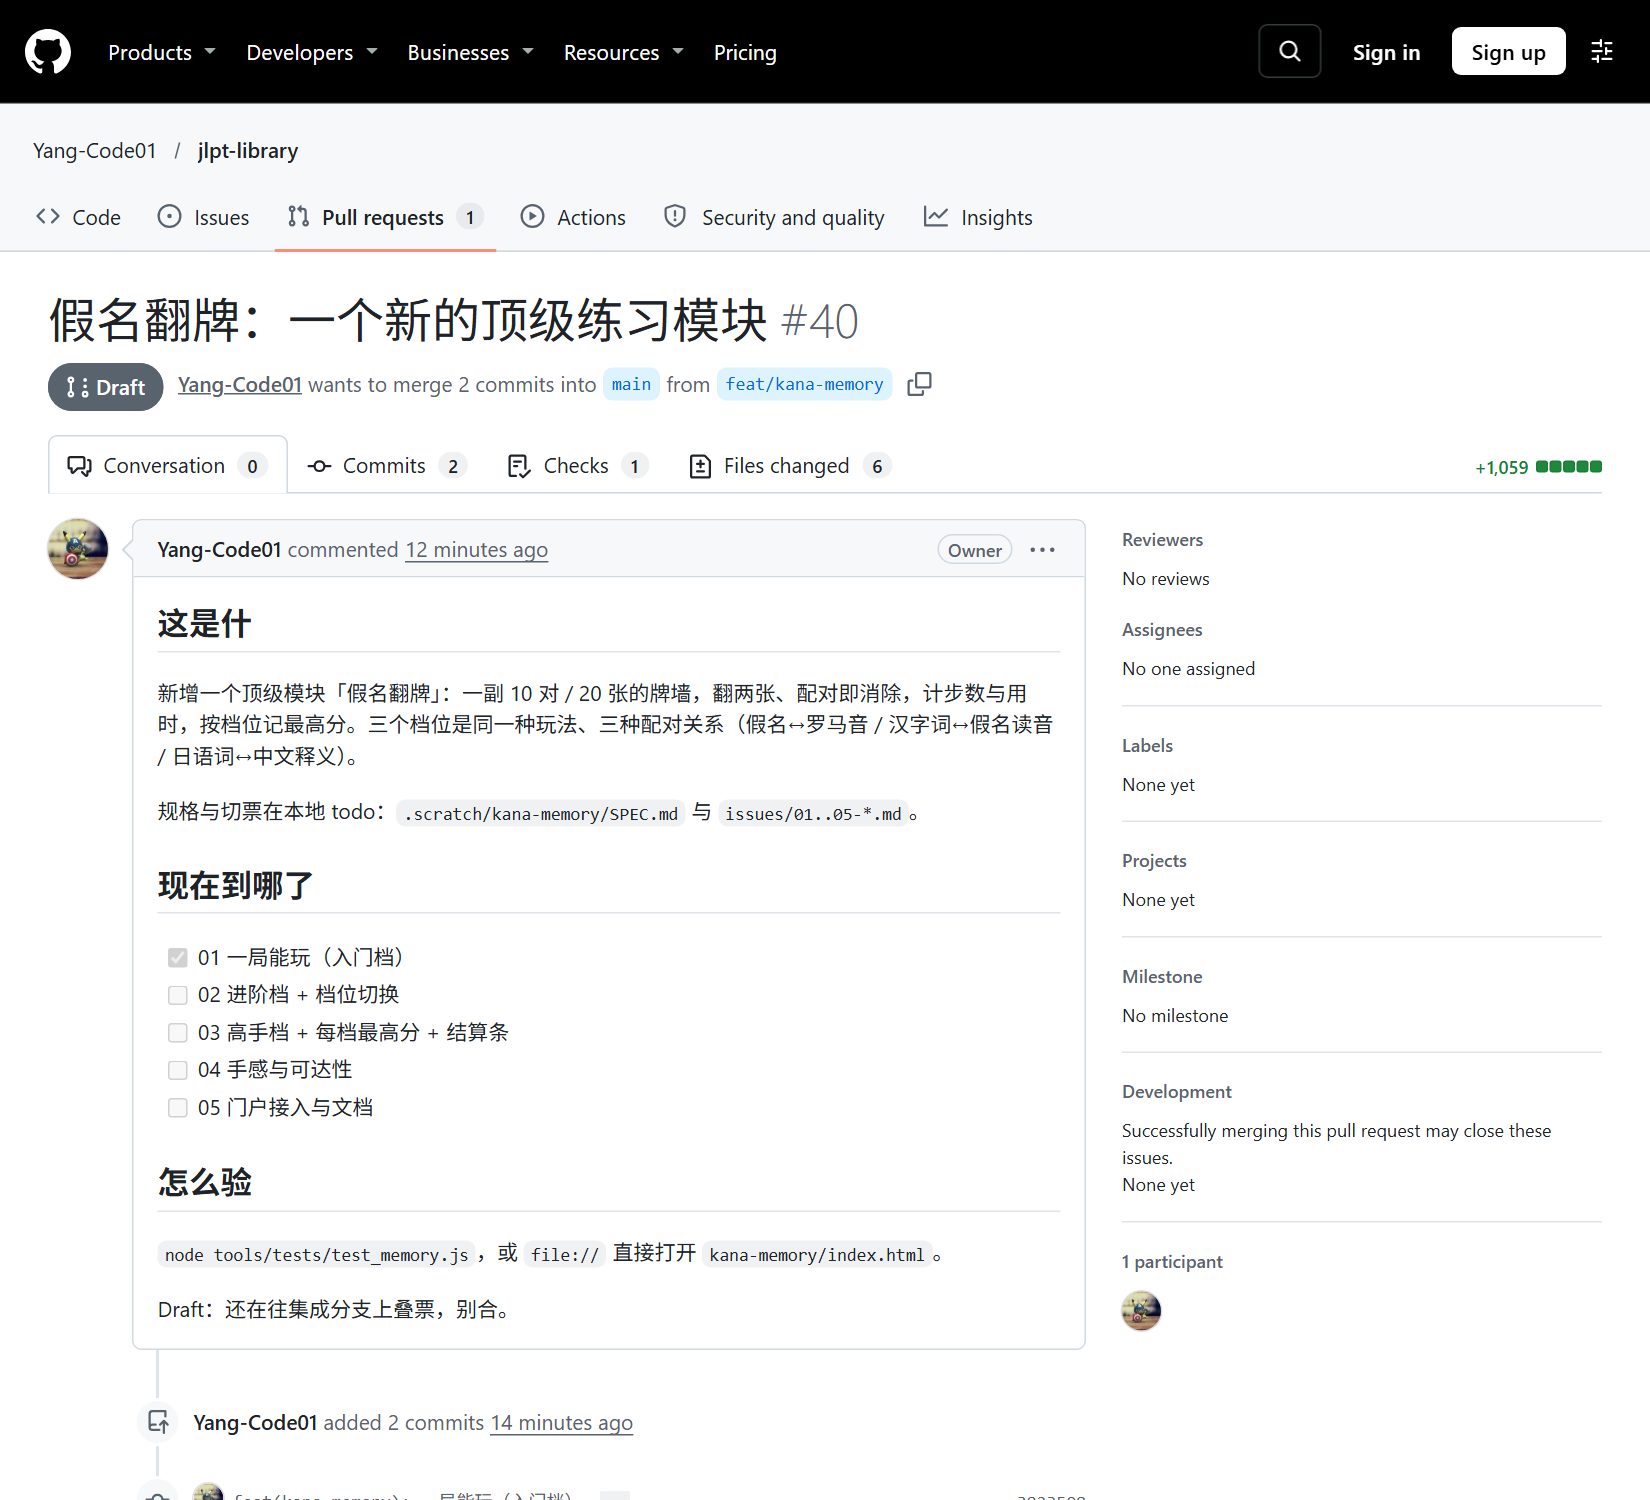
评审跑完、修补提交之后,这一版被整篇覆盖掉。定稿的第一段不再是一段话,而是一棵树加一段 diff:
kana-memory/
├── index.html      # 页面骨架:牌墙 / 四项计量 / 结算条 三个插槽区
├── kana.css        # 独立样式(不引 assets/style.css,不引 theme.js / progress.js)
├── game.js         # KanaCore:洗牌、发牌、翻牌判定、一局结算
├── tiers.js        # 入门档 假名↔罗马音 · 进阶档 汉字词↔读音
├── score.js        # 高手档 日语词↔中文释义 · 每档最高分 · 结算条
├── feel.js         # 合成音效(无音频文件)· 键盘 · 减少动效
└── page.js         # KanaApp:渲染、计时、播报、事件

index.html · 语言学习区「日本語」分组
   <article class="card" data-tags="词汇 练习">
+    <span class="pill">音效</span>
+    <h3><a href="kana-memory/index.html">假名翻牌</a></h3>
+    <div class="chips">3 档难度 · 10 对牌</div>
+    <span class="badge">3 档</span>
   </article>
第二段用 before/after 成对给:票 01 的牌墙(牌背与纸底同色、かな 1.9:1)对票 04 之后的牌墙(暖纸色 + 内衬线、7.3:1),375px 的溢出数字对 375px 的截图,最后贴四个套件的通过行和全仓 34 通过 · 2 失败——把两个红也贴上去,并写清它们是环境既有(未跟踪的第三方插件、三个英语页漂移),不是这次改出来的。
Door          two-way —— 新目录 + 一张卡 + 三处断言数字,revert 一条命令回去;
              唯一要当心的是三处断言与新卡同批改,只退一半门户测试会红。

Blast Radius  portal-only —— 只碰门户卡片清单与「12 张卡」那三处断言;
              data-en-key 一项没动(全页仍恰好 107 项),既有模块运行时一行没碰。
「单向门还是双向门」这个问题逼你想一件事:合下去之后好不好退。新目录 + 一张门户卡 + 四处断言数字,一个 revert 就回去了,是双向门;但「三处断言与新卡是同批改的」这条要写出来——只回退一半,门户测试会红。
$ HTTPS_PROXY=$PROXY gh pr edit 40 --body-file .scratch/kana-memory/pr-body.md
https://github.com/Yang-Code01/jlpt-library/pull/40
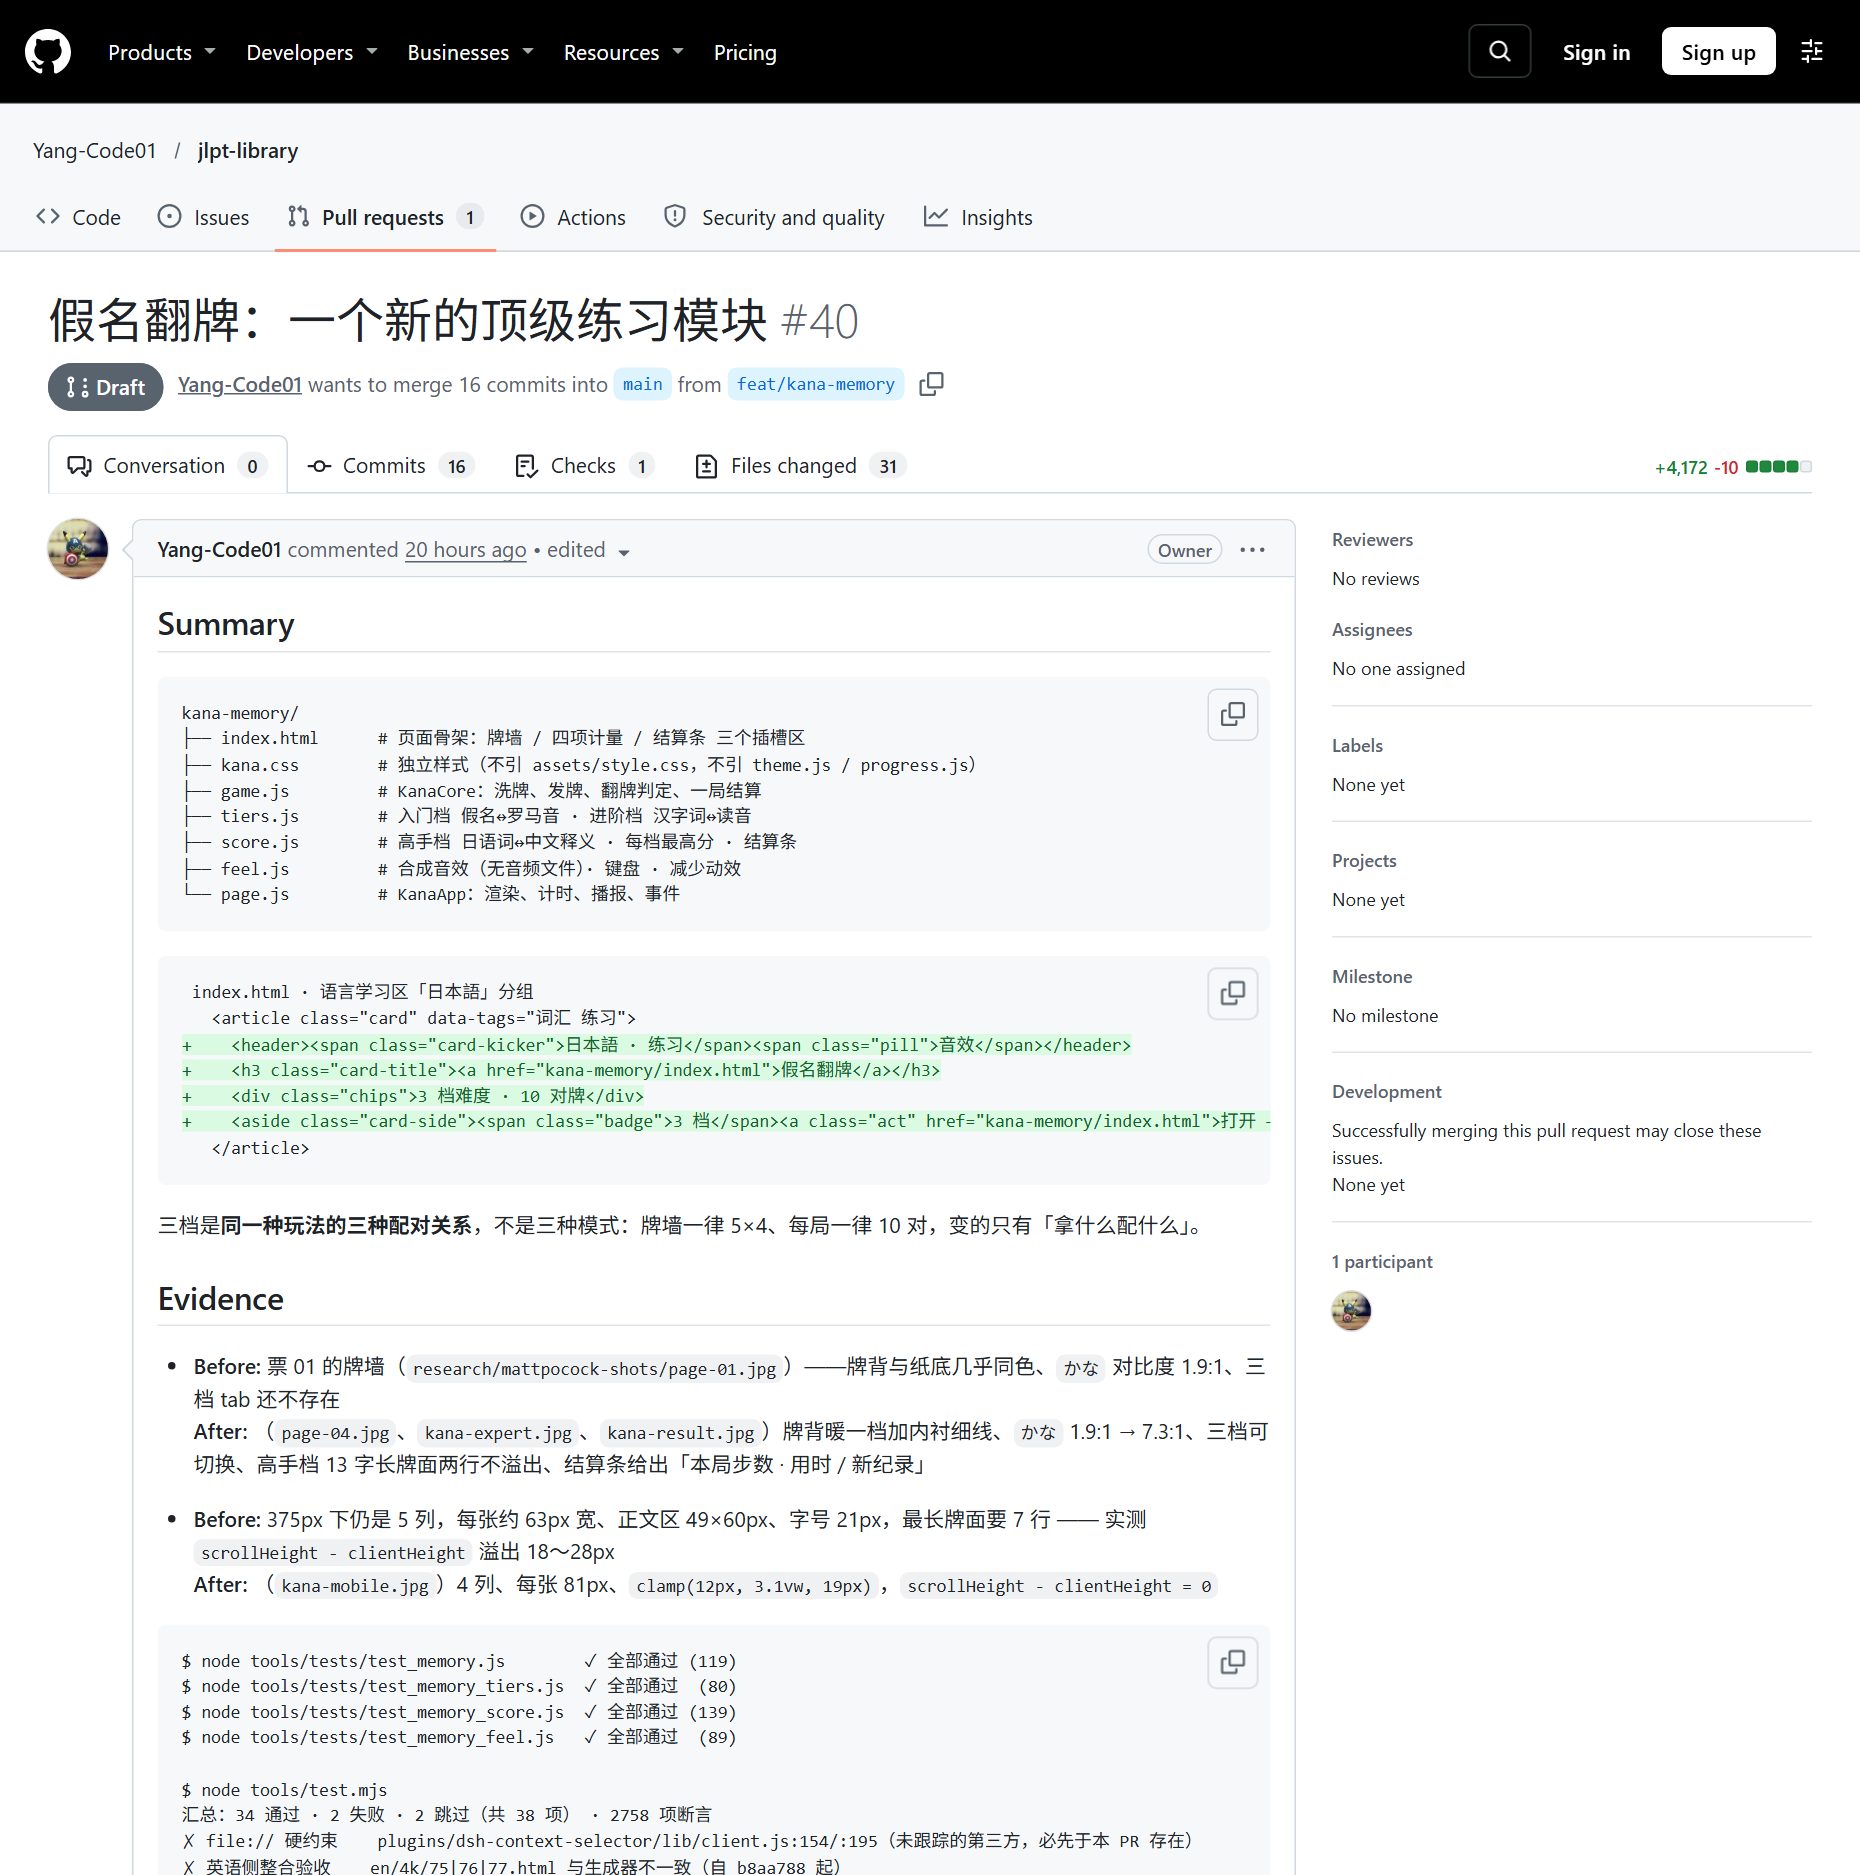
Door 与 Blast Radius 两行。PR 本身也留着:github.com/Yang-Code01/jlpt-library/pull/40(draft,base main)——这一篇里的每张截图、每个行号、每条断言计数,都能在上面逐条对上。
复盘:复的不是代码,是环境
retro — 候选按严重度排 · 机械的做成检查 · 判断的写成规范
很多人以为 retro 是「这次哪里做得不好」,retro 的靶子根本不是代码,而是下一次同类任务的环境:导航、自动化检查、编码规范、AGENTS.md、工具经济、信息获取。产物不是感想,是候选改进清单,按严重度排。
它还给了一条判断谁该干什么的原则,用一句话就能说清为什么评审要比实施更严:实施代理的上下文压力最大(要探索、写码、调错),评审代理最小(拿到 diff,不用探索)。所以规范该压在评审这一侧,实施侧只配导航指针。
8.1 这次排出来的七条
1 信息获取    评审子代理读不到 git
                两份报告开头都写着「无 git/shell 权限,main...HEAD 未亲核」
                只能把「工作区 = 分支 HEAD」当 diff:未跟踪文件、被忽略的本机文档、
                提交粒度全部看不见 → 主代理预先把三点 diff 落成快照塞进任务书

2 自动检查    「12 张卡」写死在三处测试
                test_area.js:48 · test_reading.js:283 · test_typing_en.js:380
                每上一个模块改三遍 → 改成从 portal 的桶推导,张数不是不变量

3 工具经济    为六张证据图写了八个 shot-*.mjs(同一件事的八个小变体)
                → 入库一个 tools/shoot.mjs:文件 / 锚点 / 视口 / 动作脚本

4 自动检查    guardNoFetch 误报第三方:一个未跟踪的 plugins/ 插件点亮了「禁 fetch」
                → vendored 白名单,或只扫本站运行时可达的文件

5 steering    AGENTS.md 太肥 · 6 票号注释过期 · 7 两处 append-only 区域注定冲突
                → 指针化 / 机械的做成检查 / 冲突解法写成一行可执行的话
这七条里没有一条是「下次写 CSS 要更小心」。这正是它跟「自我检讨」的区别:能自动化的就不要写进规范,规范只留给判断类(比如「源码注释只描述当前行为,票号只出现在提交说明里」)。
8.2 走到这里,这条流水线交出了什么
| 阶段 | 产物 | 规模 |
|---|---|---|
| 01 拷问 | 决策表(题材 / 完成度 / 分支 / 截图形态) | 4 轮问题 |
| 02 样张 | 三份能点开玩的 HTML + 目录页 | 3 份 · 选 1 |
| 03 规格 | SPEC.md(问题 / 方案 / 16 条故事 / 决策 / 测试 / 不做) | 6 节 |
| 04 切票 | 5 张 tracer bullet 票 + 依赖图 | 5 张 |
| 05 实施 | 模块 7 个文件 + 4 个套件 + 门户接入 + ADR | 1202 行 · 427 条断言 |
| 06 评审 | 两轴报告 + 一个修补提交 | 1 硬 + 12 判断 · 修 6 条 |
| 07 交付 | PR #40 正文(Summary / Evidence / Merge Danger) | 3 段 |
| 08 复盘 | 七条环境改进候选 | 7 条 |
整条链子的摩擦只集中在三个地方:契约的边界(三个子代理各自撞上同一处守卫)、共享文件的追加区(每次合并都冲突)、评审看不见 git。剩下的事——切片、并行、测试、截图——都顺得像走过很多遍的路。这也算这个 flow 的实测结论:它省下的是返工,不是思考;省不掉的地方全在接口上。
这套流水线里,有三种活不该走主线
triage · diagnosing-bugs · wayfinder · improve-codebase-architecture
主线的假设是「你知道要做什么,只是还没想清怎么做」。有三类活不满足这个假设,硬套主线会得到一份规格性很强的错误答案。
| 什么时候叫它 | skill | 它做完之后你手上多出什么 |
|---|---|---|
| 别人(或未来的自己)塞给你一堆 issue / 外部 PR,乱七八糟没分诊 | triage | 每一条都被分成「需补充 / 可交给 agent / 需人工 / 不做」,可交给 agent 的那些还附了一份能直接开工的简报 |
| 它不是「要加什么」,而是「坏了」——报错、慢、偶发 | diagnosing-bugs | 一条能复现的证据链和最小修法,而不是一圈猜测式改动 |
| 你连「下一步该往哪走」都不知道,方向比方案更缺 | wayfinder | 一张把可能性摊开的地图,以及一条便宜的验证路径 |
| 没有新需求,但你感觉这块代码越来越难改 | improve-codebase-architecture | 按「深模块」重新划一遍边界,给出一批可独立合入的加深手术 |
本案例一条都没走:需求是新的、没有故障、方向从一开始就明确(新开一个练习模块)、模块本身是新建的(没有历史包袱可体检)。不用某个 skill 不是缺失,是因为它解决的问题这次不存在。左栏把 handoff 也留在这里,理由相同——这一整轮从访谈做到复盘都在同一个会话里,没有需要交接给下一个会话的断层。
如果一个会话做不完(上下文要满了),或者要换人接手,就必须把「已经谈定的决定 + 现在做到哪 + 下一步的入口」压成一份文件。它的写法与本篇的流水线一致:指针多于复述——写「规格在哪个文件、第几张票没做完、分支叫什么」,而不是把规格抄一遍。